Как замороженный LLM читает речь: индукционные головы внимания в SLAM-ASR
В SLAM-ASR языковая модель распознаёт речь, хотя её веса не обучались на аудио: небольшой проектор переводит акустические признаки в понятное ей пространство. Авторы находят внутри замороженного LLM головы, изначально умеющие продолжать повторяющиеся текстовые последовательности. Усиление этих голов иногда уменьшает шумовые вставки, но эффект зависит от модели и не заменяет надёжное улучшение речи.
Метод. Whisper turbo и Llama 3.2-3B, Gemma 2-2B либо текстовый декодер Ministral 3-3B заморожены. На 100 часах LibriSpeech обучается лишь двухслойный MLP-проектор с промежуточной шириной 2048; пять соседних акустических состояний объединяются в один вектор длительностью 100 мс. Индукционные головы находят отдельно, без аудио: модели показывают повтор случайной последовательности токенов и измеряют внимание к продолжению предыдущего вхождения. Затем блокируют их связи с акустическими векторами или умножают выходы выбранных 3% голов на 1,5. При GQA некоторые пары с общими ключами и значениями имеют почти противоположные выходные проекции и могут подавлять нерелевантное внимание.
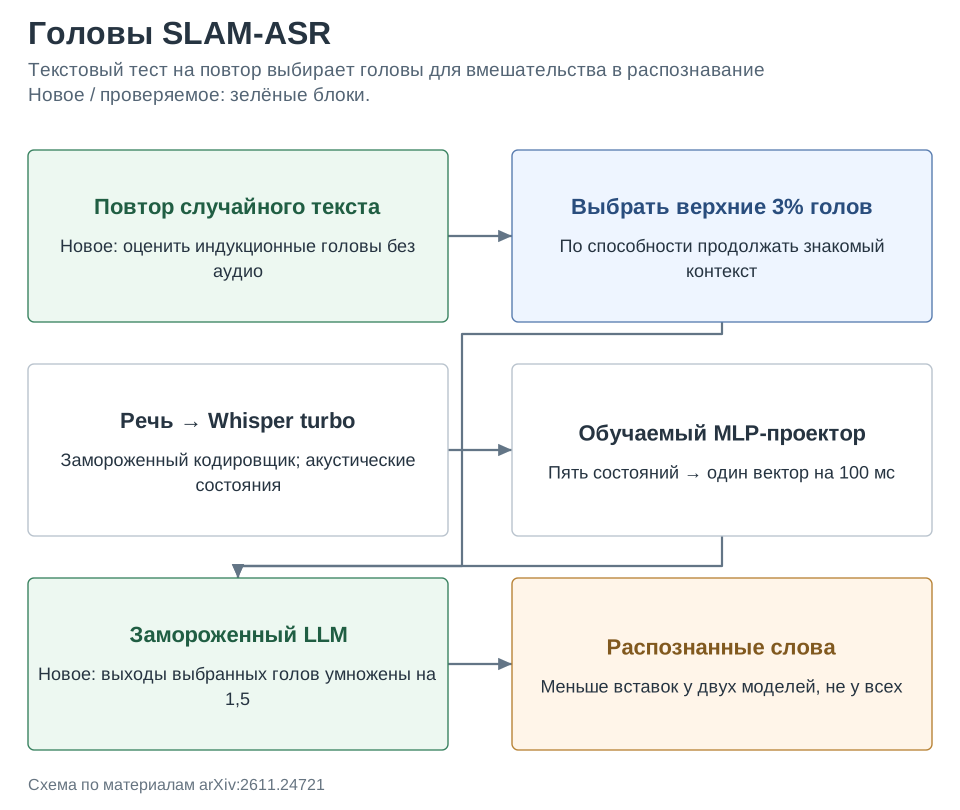
Результаты. Блокирование десяти найденных голов у Gemma повышает WER с 3,8–4,0% до 23,2–53,5% в зависимости от обучения; случайные головы из тех же слоёв дают лишь 4,0–4,2%. Это сильнее простой корреляции активации с задачей. Но вмешательство при выводе менее универсально: на разговорном шуме 0 дБ Llama улучшает WER с 89,0% до 81,8%, Ministral с 86,0% до 81,8%, а Gemma ухудшается с 148,6% до 150,0%. На чистой речи изменения малы и слегка отрицательны.
Ограничения. Проверены три небольших декодера и английское чтение. Шумовые опыты используют по 400 записей двух частей LibriSpeech; перенос на свободный разговор, другие языки и устройства не показан. «Подавление шума внимания» относится к внутренним связям, а не к удалению акустического шума из сигнала. Почти противоположные проекции не равны точному новому дифференциальному слою. Нет отдельного откалиброванного детектора галлюцинаций или гарантии, что усиливаемые головы всегда уменьшают ошибки.
Фишка из статьи. Таблица 3 отделяет WER от доли вставок I. Самый заметный эффект возникает там, где вставок особенно много, но даже здесь одна из трёх моделей не выигрывает. WER выше 100% допустим: вставленных слов может быть больше, чем слов эталона.
| Модель, babble 0 дБ | WER до → после, % | Вставки до → после, % |
|---|---|---|
| Llama | 89,0 → 81,8 | 40,4 → 32,1 |
| Gemma | 148,6 → 150,0 | 94,9 → 94,7 |
| Ministral | 86,0 → 81,8 | 39,3 → 34,4 |
Как это читать: уменьшение вставок не гарантирует меньшую суммарную ошибку: у Gemma почти неизменные вставки сопровождаются ростом WER. На чистой речи WER меняется соответственно 4,6→4,7%, 4,7→4,8% и 4,2→4,4%. Практический смысл вмешательства — узкая диагностика механизма чтения акустического контекста, не универсальный режим «без галлюцинаций».
Источник. Оригинальное название: Induction Head Origins of SLAM-ASR Speech Recognition Models. arXiv:2611.24721; полный текст PDF.