Почему несколько аудиособытий теряются при генерации изображения: геометрия токенов и внимание
Если по двум звуковым записям генерировать одну картинку, модель часто рисует только один источник или смешивает объекты. Авторы связывают это с геометрией аудиотокенов в текстовом пространстве CLIP и конкуренцией за внимание. Работа полезна как анализ представлений и управления условиями, но не предлагает новый аудиокодек и не разделяет источники в звуковой смеси.
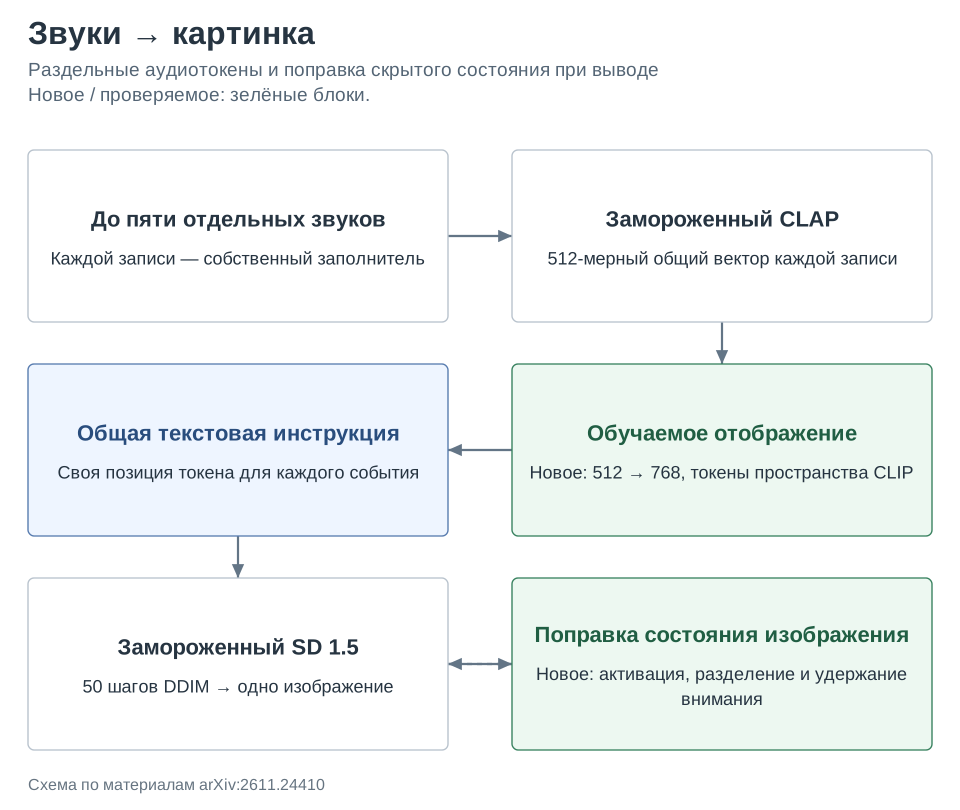
Метод. Каждый отдельный входной звук проходит замороженный CLAP с выходом 512 чисел. Обучаемый модуль около 8,3 млн параметров переводит его в нормированный 768-мерный токен текстового пространства Stable Diffusion 1.5. Для каждого звука выделяется отдельный заполнитель в общей текстовой инструкции; до пяти записей задаются раздельно. Сам генератор изображений заморожен. При применении первые 25 из 50 шагов DDIM дополнительно меняют скрытое состояние изображения по градиенту: усиливают активацию всех условий, уменьшают наложение областей внимания и удерживают их между шагами. Это оптимизация состояния при выводе, а не дообучение U-Net на каждом примере.
Результаты. На VGG2 с двумя источниками AIC, отражающий узнаваемость нужных классов, равен 0,4332 против 0,2126 у MACS; FID снижается с 57,8110 до 54,1177. Преимущество FID над AudioToken намного больше, но это более слабая база, поэтому выдавать такое отношение за выигрыш над лучшим конкурентом неверно. На одиночных классах AIC достигает 0,5904. При переносе на IS3 картина меняется: CLAP даёт AIC 0,1688, тогда как BEATs 0,2131. Узкие хорошо разделённые классы обучающего словаря не гарантируют лучшего описания незнакомого события.
Ограничения. Обучение использует около 25 тыс. пар из 50 классов VGGSound. Часть оценок связана с CLIP, поэтому семантическая близость его пространству может влиять на ранжирование; независимого прослушивания здесь по постановке нет, а человеческая проверка полноты композиции не заменена одной метрикой. Вход — набор отдельных аудиозаписей, не единственный смешанный сигнал. Итерации градиента значительно увеличивают время; эти секунды не относятся к обработке аудио в реальном времени.
Фишка из статьи. Таблица S6 раскрывает цену улучшенного внимания. При неизменных весах модели скорость всё равно может упасть втрое: нужно повторно выполнять прямые и обратные проходы. Ниже приведено измеренное авторами время генерации одной картинки в их протоколе, а не гарантированная задержка сервиса.
| Набор | Без оптимизации, с | Смешанная цель, с | Замедление |
|---|---|---|---|
| VGG2: два звука | 4,082 | 11,408 | 2,79× |
| VGG3: три звука | 4,030 | 12,027 | 2,98× |
| VGGn: 2–5 звуков | 4,032 | 12,356 | 3,06× |
Как это читать: основная цена приходится на усиление активации: до 20 внутренних итераций на трёх выбранных шагах. Одна только пространственная поправка требует 7,272 с на VGGn против 12,356 с полной цели. Для практического выбора важны одновременно присутствие всех объектов и бюджет вычислений, а не только число обучаемых параметров.
Источник. Оригинальное название: Why Multi-Source Audio Fails to Compose: A Geometric Diagnosis and Its Remedy. arXiv:2611.24410; полный текст PDF.