CounterPoint: временные траектории отличают событие от другого события в тех же условиях
Усреднённый вектор может правильно определить материал и действие, но спутать два разных касания одной поверхности. CounterPoint добавляет к такому вектору синхронную траекторию, сохраняя мелкие общие колебания звука и тактильного сигнала. Выигрыш велик, но сдвиг на один 40-мс кадр убирает большую часть преимущества.
Метод. Общие кодировщики выдают кадры раз в 40 мс. Исходная ветвь усреднённого представления сохраняется; новая линейно переводит признаки в 64 измерения и вычитает среднее каждой записи по времени. Сравниваются именно совпадающие моменты траекторий, без поиска сдвига или DTW. Итоговый балл складывает сходство общих векторов и нормированную согласованность траекторий. При обучении отрицательным примером служит другое выполнение того же движения в тех же условиях: сеть не может решить задачу только по материалу или скорости. Добавка параметров составляет 0,4%, пиковой памяти обучения — 0,7%. Теоретическое объяснение потери событий при усреднении опирается на условия стационарности и перемешивания, а не утверждает бесполезность любого агрегирования.
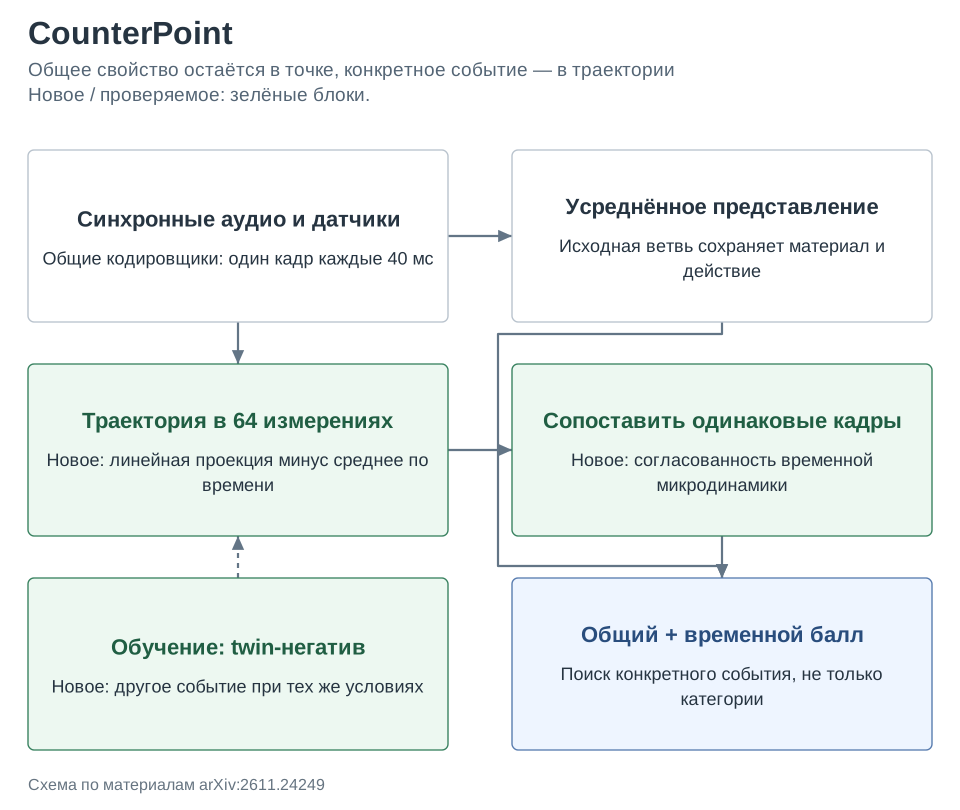
Результаты. На Cluster Haptic Texture робот повторяет движения по 118 текстурам, меняя направления, скорость и силу. Для TRIANGLE средний R@1 межмодального поиска растёт с 19,4% до 40,0%, а точность различения двух событий в одинаковых условиях с 58,5% до 81,1%. Поиск между звуком и осязанием даёт 58,2% вместо 27,4%. На HAVdb с движениями десяти людей средний R@1 возрастает с 8,7% до 87,4%. Однако визуальный канал роботного набора содержит главным образом траекторию, не микровариации контакта: задача HA→V почти не улучшается, 3,4→3,5%.
Ограничения. Это синхронизированные физические события, не проверка распознавания речи или говорящего. Для реального аудиовизуального потока потребуется контроль часов и задержек датчиков. Малое число новых параметров скрывает цену поиска: 1000 запросов по миллиону кандидатов занимают 145 мс вместо 34 мс у одних общих векторов в данном измерении. Надёжность при дрейфе времени, пропусках кадров и несопоставимых сенсорах отдельно не доказана.
Фишка из статьи. Абляция таблицы 4 отличает пользу синхронизации от просто дополнительной обучающей цели. Один кадр смещения кандидата снижает средний поиск почти до исходного уровня. При этом исключение специальных отрицательных примеров вредит гораздо меньше.
| Вариант на Cluster | R@1 звук–осязание, % | Средний R@1, % | Точность события, % |
|---|---|---|---|
| Полный CounterPoint | 58,2 | 40,0 | 81,1 |
| Сдвиг кандидата 40 мс | 32,3 | 22,7 | 60,7 |
| Сдвиг 160 мс | 29,0 | 20,4 | 59,1 |
| Перестановка кадров | 29,0 | 20,5 | 59,2 |
| Без twin-негативов | 55,7 | 38,3 | 78,8 |
Как это читать: новая ветвь действительно использует совпадение микродинамики, а не только более богатую статистику всей записи. Это одновременно объяснение успеха и инженерное ограничение: синхронизация здесь часть метода, не второстепенная предварительная обработка. Визуальная траектория, не несущая информации о конкретном контакте, не становится информативной от одного выравнивания.
Источник. Оригинальное название: From Points to Trajectories: Rethinking Multimodal Alignment for Physical Events. arXiv:2611.24249; полный текст PDF.