Голос и манера речи в синтезе: почему важно, в какие слои подавать текстовые условия
Описание голоса и описание манеры речи конкурируют внутри синтезатора, даже если заданы двумя отдельными инструкциями. Авторы не усложняют сеть, а переставляют эти условия между ранними и поздними слоями. Раннее условие голоса лучше удерживает личность диктора, раннее условие стиля расширяет выразительность, но единого победителя по всем критериям нет.
Метод. Кодировщик фонем и модуль выравнивания питают шестиблочный декодер дискретных WavTokenizer-токенов. Два текстовых описания отдельно проходят T5-large и проекции. Перед перекрёстным вниманием слоя l они смешиваются как σ(αl)·стиль + (1−σ(αl))·голос. Коэффициенты фиксированы, а не обучаются: Equal даёт равные веса; Style-early почти полностью подаёт стиль в слои 1–3, голос в 4–6; Voice-early меняет порядок. Concat объединяет описания в одну строку. Такой контроль изолирует место введения условия от способности обучаемого маршрутизатора подобрать веса. Обучение использует 515,1 часа LibriTTS-R, 2295 дикторов, 81 сочетание признаков стиля и 243 описания голоса.
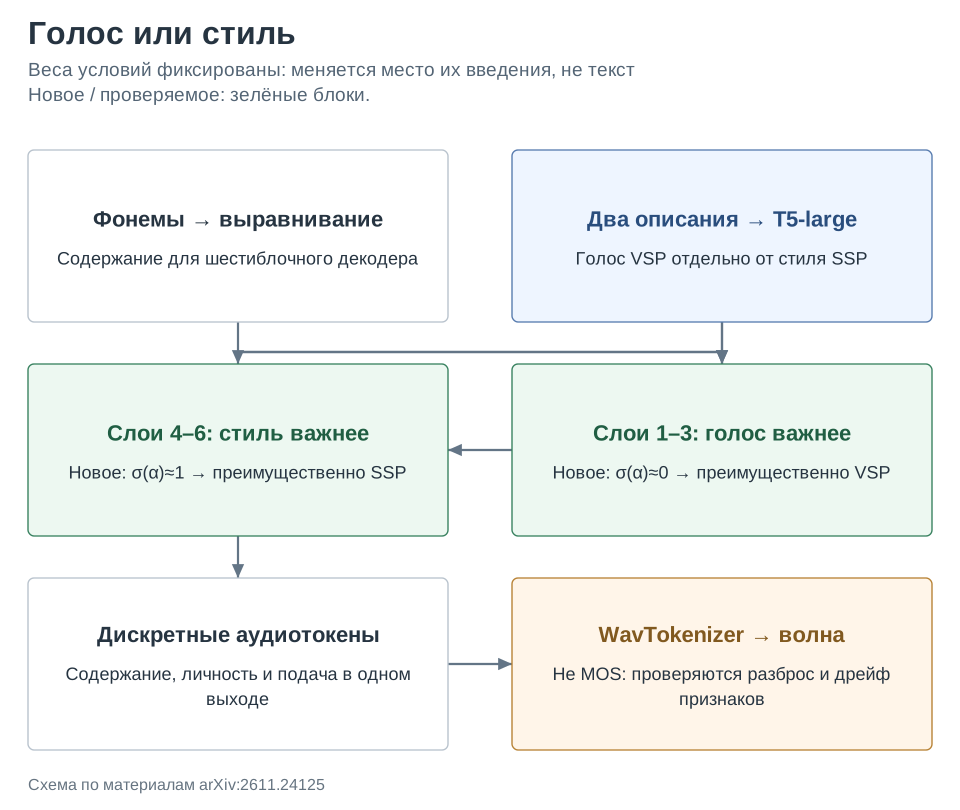
Результаты. Голос оценивают векторами ECAPA-TDNN, TitaNet и WavLM, стиль — семью акустическими признаками с двумя моделями эмоций. Spread измеряет разброс при изменении целевого условия; drift — изменение того же свойства, когда меняется другое условие. Поэтому большой spread желателен, а большой drift нет. Для Voice-early дрейф ECAPA равен 0,227 против 0,250 у Concat; аналогичный порядок сохраняется в двух других пространствах. Style-early даёт максимальный стилевой разброс: 3,536 у Audeering против 3,300 у Concat. Модель смешанных эффектов учитывает, что разные сравнения используют одни и те же звуковые примеры.
Ограничения. Это оценки по признакам, а не доказанное слушателями различие в естественности или точности следования инструкции. Обучающий материал преимущественно нейтральные аудиокниги, а часть описаний размечена на уровне диктора, не отдельной реплики. Проверена одна архитектура. При замене структурированных описаний разнообразными естественными шаблонами многие стилевые эффекты ослабевают; сохранность голоса оказывается устойчивее. Свободную длинную инструкцию нельзя считать эквивалентом перебора фиксированных категорий.
Фишка из статьи. Таблицы 3–4 раскрывают важный компромисс: расширение стилевого диапазона не равно независимому управлению стилем. Раннее введение стиля увеличивает и полезную вариативность, и нежелательный дрейф. Ниже — абсолютные средние для структурированных описаний, а не неоднозначно ориентированные попарные разности.
| Условия | Дрейф голоса ECAPA ↓ | Разброс стиля ↑ | Дрейф стиля ↓ |
|---|---|---|---|
| Concat | 0,250 | 3,300 | 2,897 |
| Style-early | 0,250 | 3,536 | 3,033 |
| Voice-early | 0,227 | 3,239 | 2,941 |
| Equal | 0,242 | 3,461 | 3,133 |
Как это читать: раздельные каналы сами по себе не развязывают свойства: Equal сохраняет стиль хуже всех четырёх вариантов по этой мере. Для клонирования личности разумен приоритет раннего голоса, для широкого диапазона подачи — раннего стиля. Но эти числа не измеряют ни MOS, ни совпадение с заданной эмоцией напрямую.
Источник. Оригинальное название: Location Matters: Layer-wise Prompt Conditioning for Voice--Style Disentanglement in Text-to-Speech. arXiv:2611.24125; полный текст PDF.