Слышать недостаточно: слой решений между аудиоагентом и выполнением команды
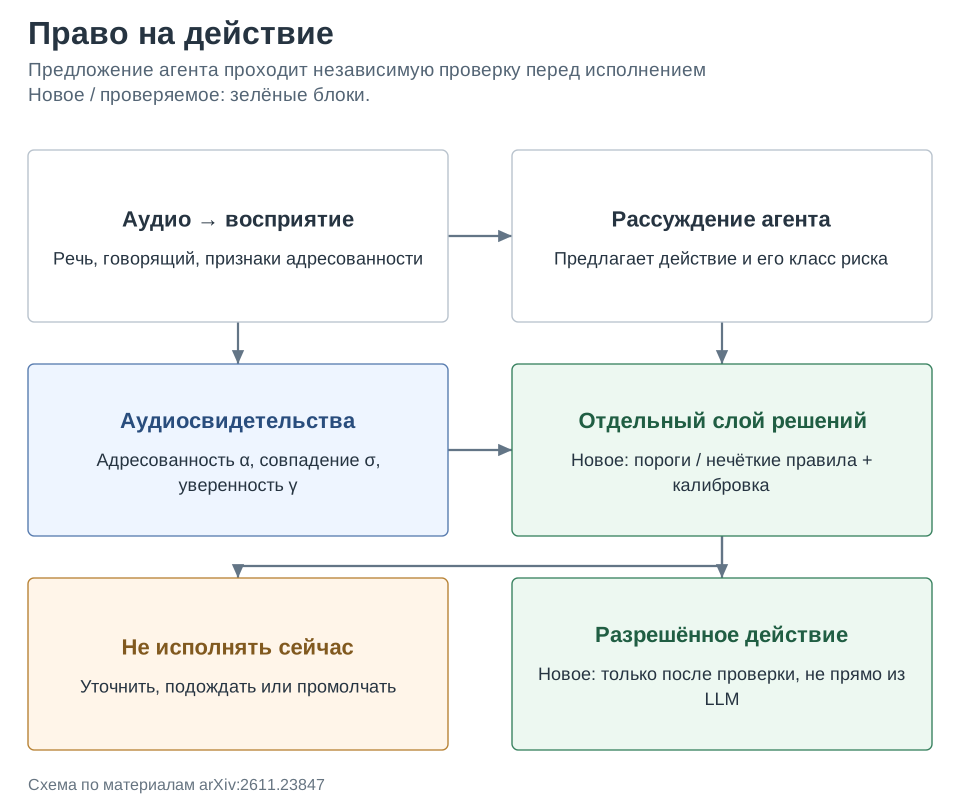
Агент может правильно услышать слова и всё равно не должен выполнять команду: она могла быть обращена к другому человеку, произнесена неуполномоченным голосом или ещё не закончена. Авторы вводят отдельный слой, который получает предложенное действие и решает: выполнить, подождать, уточнить или промолчать. Ценность работы — в явном разделении качества распознавания и права на действие, а не в доказанном превосходстве нечёткой логики.
Метод. Слой объединяет адресованность речи α, сходство с разрешённым диктором σ, уверенность в содержании γ, согласие инструментов, завершённость фразы и риск действия. У нечёткого варианта минимум реализует совместное выполнение условий, максимум объединяет правила; параметры функций принадлежности подбираются NSGA-II с учётом ошибок и количества вопросов. С ним сравниваются настроенные пороги и произведение вероятностей. На записанном аудио α берут из Qwen2-Audio, γ — из вероятностей Whisper large-v3, σ — из ECAPA на наборе со сменой говорящего. Часть данных отводят калибровке, остальные 70% — проверке. Ожидание конца фразы и доверие инструментам отдельно исследуются в моделируемых эпизодах, не в живом диалоге.
Результаты. На WearVox с 582 посторонними разговорами и 500 корректными запросами прямое выполнение срабатывает на постороннюю речь в 41,2% случаев. Настроенный нечёткий слой снижает долю до 7,9%, задавая вопросы в 33,4% случаев; настроенные пороги дают сопоставимые 7,4% и 33,0%. На VGBench правильное молчание при смене диктора растёт с 3,1% до 65,8%. При этом показатель обслуженных запросов 84,6% предполагает, что каждый заданный вопрос успешно разрешает неопределённость. При вероятности успеха уточнения 0,8 он падает до 79,0%.
Ограничения. Ответы людей на уточняющие вопросы фактически не собирались. Нельзя трактовать расчётный показатель обслуживания как измеренную успешность разговорного продукта. Для проверки завершённости и ошибок инструментов использована симуляция; перенос этих выводов на запись остаётся гипотезой. Около трети запросов требует вопроса, что может быть неудобно. Сам шлюз дешевле 0,1 мс на GPU, но вычисление аудиопризнаков и адресованности существенно дороже; это не задержка всей системы.
Фишка из статьи. В таблице X важнее замена источника свидетельства, чем выбор формулы шлюза. Если судить, кому адресована речь, только по расшифровке, тот же нечёткий механизм резко теряет защиту. Пороговый вариант с исходным аудио не уступает более сложному.
| Вариант | Посторонняя речь выполнена, % ↓ | Вопросы, % | Верное молчание, % ↑ |
|---|---|---|---|
| Прямое действие | 41,2 | 0,0 | 3,1 |
| Настроенные пороги, аудио | 7,4 | 33,0 | 66,5 |
| Нечёткий слой, аудио | 7,9 | 33,4 | 65,8 |
| Нечёткий слой, α из текста | 21,6 | 31,2 | 24,9 |
Как это читать: сходная нагрузка вопросами не гарантирует сходной безопасности. Текст теряет интонацию, пространственные и разговорные признаки адресованности. Но эксперимент не позволяет объявить один универсальный шлюз безопасным: пороги зависят от цены ложного действия, корпуса и калибровки входных оценок.
Источник. Оригинальное название: Great Listeners, Poor Decision-Makers: Rethinking Agentic Audio AI. arXiv:2611.23847; полный текст PDF.