Как выделить речь учителя без образца его голоса: центральность кластеров вместо регистрации
В записи урока голос учителя часто образует акустический центр нескольких кластеров, даже если обычная кластеризация раздробила его на сотни частей. Авторы используют эту структуру для определения роли говорящего без отдельного образца нового учителя. Метод достаточно лёгок для телефона, но выделение нужной роли не обязательно улучшает распознавание её слов.
Метод. Silero VAD находит речь; окна по 1,25 с с шагом 0,5 с проходят WeSpeaker ResNet34, выдающий 256-мерные векторы. Агломеративная кластеризация использует косинусную меру и порог 0,5. Для каждого кластера считают восемь относительных признаков; главный — сходство его центра со средним вектором всей записи, взвешенным по длительности. Логистический классификатор с порогом 0,45 может назначить учителю несколько кластеров, а не только самый длинный. Он обучается на размеченных уроках; «без разметки» относится к применению на новом уроке, не к обучению вообще. Проверка исключает все уроки проверяемого учителя.
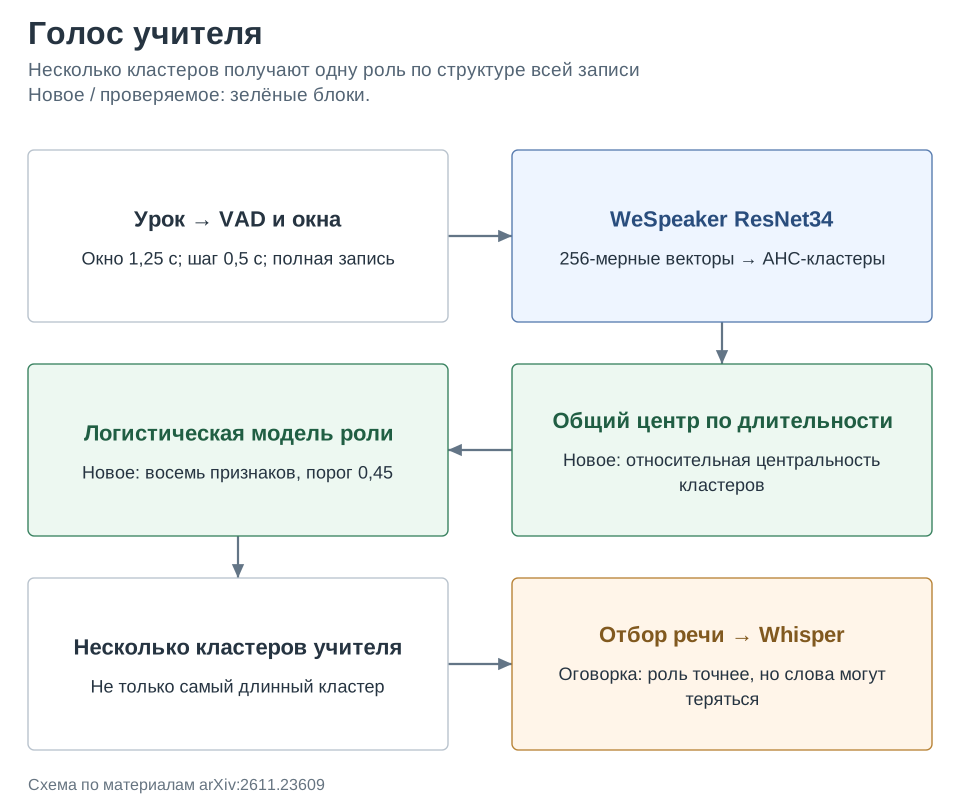
Результаты. На 151 английском уроке 24 учителей F1 роли равен 0,81±0,04, на 141 немецком уроке 39 учителей — 0,87±0,05. Регистрация по 30-секундному образцу даёт 0,65 и 0,77. pyannote лучше на английском (0,84), но хуже на немецком (0,82). Полный конвейер на Galaxy S24+ достигает RTF примерно 0,18–0,23 на двух записях, на MacBook M4 Pro около 0,022; загрузка модели исключена. Пиковая RSS составляет 356 МБ на телефоне и 872 МБ на ноутбуке, а не только размер весов.
Ограничения. Среднее по полной записи делает способ офлайн-обработкой, хотя RTF меньше единицы. Английские записи сделаны близким микрофоном, немецкие — комнатными: язык и акустические условия не изолированы. Исходные метки уроков неточны; основной протокол оценивает первые четыре секунды после начала размеченной реплики. Фильтрация перед Whisper large-v2 повышает английский WER слов учителя с 16,0% до 21,3%: меньше вставок, но больше потерянных настоящих слов. Поэтому F1 роли и итоговая ценность расшифровки должны проверяться отдельно.
Фишка из статьи. Таблица 9 показывает нетривиальный предел распараллеливания. Почти 96% времени на телефоне занимает извлечение векторов, однако добавление потоков помогает устройствам по-разному. Это измерения одной записи B с ONNX CPU, после прогрева; они не включают загрузку модели.
| Потоки | RTF: телефон ↓ | RTF: ноутбук ↓ |
|---|---|---|
| 1 | 0,228 | 0,027 |
| 2 | 0,190 | 0,031 |
| 4 | 0,137 | 0,027 |
| 8 | 0,133 | 0,036 |
Как это читать: восемь потоков почти вдвое ускоряют телефон, но делают ноутбук медленнее одного потока. «Больше ядер» здесь не универсальная оптимизация. Ещё один отрицательный результат: удаление окон с обнаруженным перекрытием из расчёта центров меняет F1 максимум на 0,002; шум нескольких процентов окон не объясняет основные ошибки роли.
Источник. Оригинальное название: Label-Free Role-Aware Segmentation of Classroom Recordings: Recovering the Teacher from Transferable Structure. arXiv:2611.23609; полный текст PDF.