Nunchi: речь помогает определить, на кого смотрят участники разговора
Когда рядом несколько людей, одна геометрия взгляда не всегда позволяет понять, на кого направлено внимание. Nunchi добавляет к ней сведения о текущем говорящем и содержании реплик, связывая все подсказки с одними и теми же лицами. Особенно интересна проверка взаимодополняемости: текст сам по себе почти бесполезен, но начинает помогать после указания того, кто говорит.
Метод. Замороженный Gaze-LLE строит тепловую карту взгляда наблюдателя; для каждого лица вычисляют массу карты в расширенной области, положение пика и расстояния. Замороженный LR-ASD по звуку и дорожкам лиц оценивает активного говорящего. Текущая и две предыдущие реплики превращаются в текстовую подсказку: имена участников заменены общими метками O и Ck, подписи авторов реплик удалены, чтобы сведения о говорящем поступали отдельным путём. Все признаки записываются текстом, согласованным с метками на ключевом кадре. Qwen3-VL-8B получает кадр, обрезку наблюдателя и подсказки; обучается LoRA языковой части, зрительный кодировщик заморожен. Решение — максимальный логит индекса кандидата до генерации объяснения, поэтому качество последующего объяснения не используется для выбора.
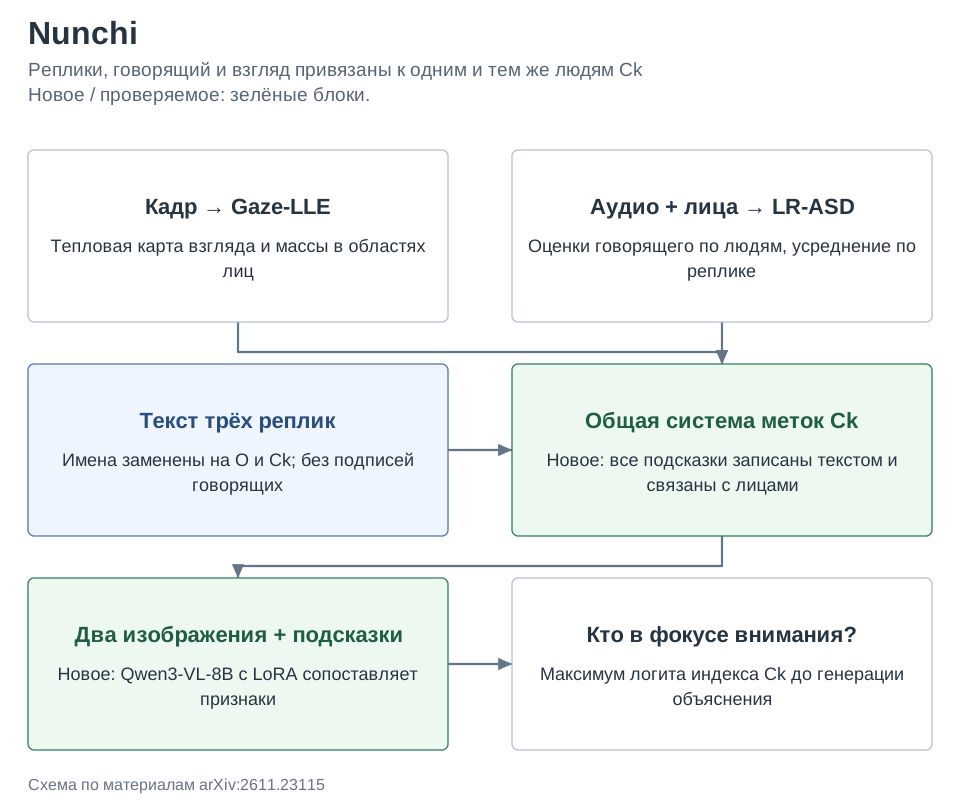
Результаты. SORBET содержит 3340 отобранных пар «кадр–наблюдатель» из 241 эпизода Friends, The Big Bang Theory и Superstore; тест — 843 примера с непересекающимися эпизодами. Полный Nunchi достигает точности личности 86,7% против 81,9% лучшего адаптированного Gaze-LLE; при пяти и более кандидатах — 76,0% против 68,0% лучшей базовой альтернативы. Замена ручных текстов распознаванием Whisper снижает общую точность лишь до 86,4%. На AVA-LAEO без дообучения добавление разговорных признаков даёт 91,0%, но на VGS перенос существенно труднее.
Ограничения. Сериалы постановочные, кадр один, а отбор предполагает взгляд на одного из перечисленных людей. Объекты, взгляд за кадр и переходы внимания исключены; исходно лишь 45,8% размечаемых примеров имели человека-кандидата как итоговую цель. Привязка имён к лицам требует известных личностей. Это не сквозное понимание сырого аудио и не готовая система внимания для произвольного совещания; измеренных задержки и стоимости полного набора экспертов нет.
Фишка из статьи. Таблица 5 показывает, что ценность реплики определяется её связью с участниками. Дополнительные зрительные признаки — глубина, взаимные взгляды, граф и стрелка — не улучшили исходный вариант. А сочетание двух разговорных подсказок сильнее суммы их отдельных эффектов, особенно в многолюдном кадре.
| Подсказки поверх геометрии взгляда | Все примеры, % | ≥5 кандидатов, % |
|---|---|---|
| Без разговорных | 83,3 | 67,0 |
| Только говорящий | 85,2 | 74,0 |
| Только текст | 83,2 | 64,0 |
| Говорящий + текст | 86,7 | 76,0 |
Как это читать: текст без адресной опоры даже немного ухудшает результат, тогда как поверх говорящего добавляет 1,5 процентного пункта. Для практической системы это аргумент в пользу согласованных идентификаторов людей между модулями, а не простого добавления ещё одной текстовой модальности.
Источник. Оригинальное название: Nunchi: Ears Help Eyes in Multi-Party Conversations. arXiv:2611.23115; полный текст PDF.