Повышение порядка Ambisonics: выбор отражений во времени и частотно-временной области
Чтобы улучшить пространственную точность записи Ambisonics первого порядка, необязательно одинаково усложнять всю звуковую сцену. Работа сравнивает повышение порядка только наиболее важных прямых и отражённых компонентов: на всю запись, на короткий кадр или отдельно в каждой частотно-временной ячейке. Последний вариант особенно полезен, когда несколько говорящих занимают разные участки спектра, но результат получен при заранее известных отражениях.
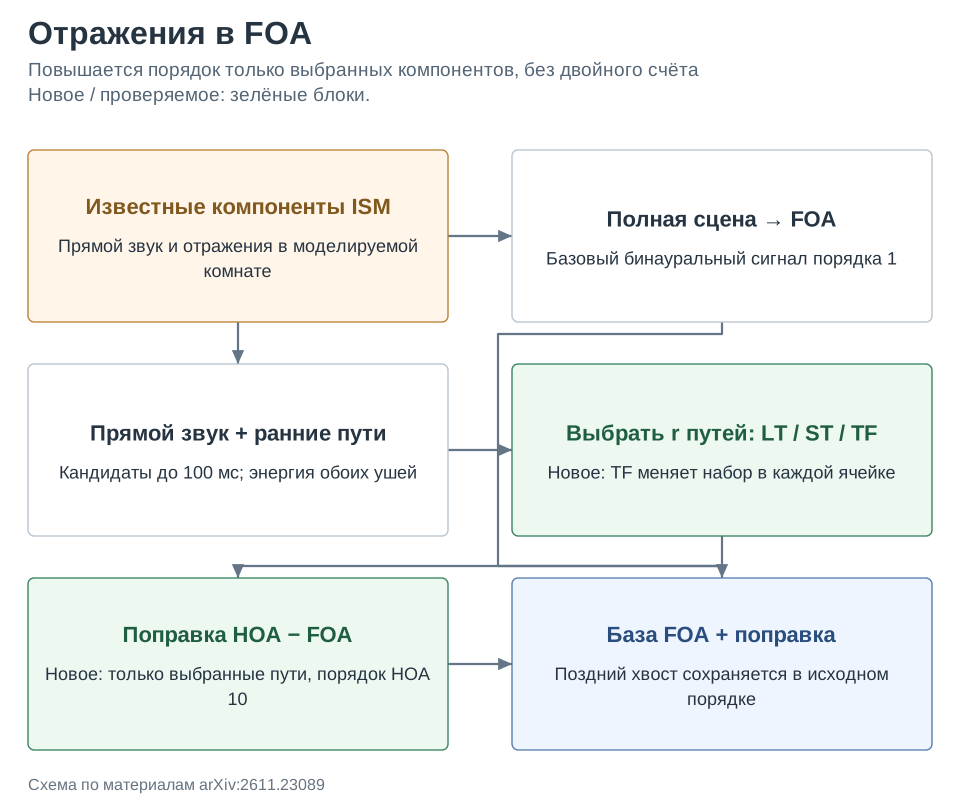
Метод. Базовый бинауральный сигнал строят из полной FOA-сцены. Для выбранных путей к нему добавляют разность их представлений высокого и первого порядка: HOA минус FOA, чтобы не посчитать компонент дважды. Рассматриваются прямой звук и ранние отражения до 100 мс; поздний хвост сохраняется в первом порядке. LT выбирает r наиболее энергичных путей на всю запись, ST пересматривает набор в окнах Hann 32 мс с шагом 16 мс, TF — в ячейках STFT с усреднением энергии по области 3×3. Энергия суммируется по обоим ушам, поэтому левый и правый сигналы используют один набор путей. Высокий порядок в экспериментах равен 10. Это адаптивный выбор компонентов при фиксированном STFT, а не новое адаптивное преобразование наподобие EMD или VMD.
Результаты. Моделирование охватывает шесть комнат объёмом 72–1800 м³, T60 0,3–0,8 с и 180 сцен с одним–четырьмя говорящими. При r=30 глобальный SI-SDR равен 17,66 дБ для TF против 15,64 для ST и 15,56 для LT. В прослушивании участвовали десять сотрудников лаборатории; использованы только две сцены с достаточно высоким отношением прямого звука к реверберации. В сцене с двумя голосами и r=1 все слушатели оценили TF как неотличимый от эталона; средние оценки LT и ST составили примерно 55 и 76 из 100. Это оценка пространственного сходства, не разборчивости слов.
Ограничения. Компоненты создаются методом мнимых источников и доступны по отдельности: из реальной четырёхканальной записи их ещё предстоит оценить. Не моделируются ошибки разделения и практические ограничения массива. При низком отношении прямого звука к реверберации заметной разницы в предварительном прослушивании не обнаружили, и такие сцены не вошли в формальный тест. Нет измерения стоимости конечного устройства или гарантии потоковой задержки.
Фишка из статьи. Таблица 2 показывает не монотонное преимущество более частого обновления, а зависимость от того, что именно выбирается. Для двух голосов один компонент на ячейку TF может представлять разные прямые пути в разных частотах. Три компонента на короткий кадр, напротив, всё ещё способны временно пропустить нужный прямой путь.
| Сцена | LT: SI-SDR, дБ | ST: SI-SDR, дБ | TF: SI-SDR, дБ |
|---|---|---|---|
| Один голос, r=1 | 16,41 | 16,43 | 16,64 |
| Два голоса, r=1 | 4,69 | 10,05 | 15,65 |
| Два голоса, r=3 | 16,61 | 12,32 | 19,35 |
Как это читать: r задаёт число путей в одной области выбора, не общее число уникальных отражений за запись. В последней строке LT лучше ST, хотя обновляется реже; при прослушивании LT и TF уже достигли потолка 100. Превосходство TF над ST при r=3 не подтвердилось непараметрической проверкой после поправки, поэтому этот край таблицы не стоит превращать в общий закон.
Источник. Оригинальное название: Insight into Parametric First-Order Ambisonics Upscaling in Time and Frequency Domains. arXiv:2611.23089; полный текст PDF.