Social Signal Bench: оценка совместно возникающих социальных сигналов в звуке и видео
Нерешительность, заинтересованность и уверенность могут проявляться одновременно, а близкие состояния люди размечают по-разному. Social Signal Bench сохраняет многометочную разметку и предлагает EW-F1: ошибочный, но близкий по смыслу сигнал получает частичный зачёт, а эталонные метки взвешиваются по накопленным свидетельствам. Это попытка изменить не только набор данных, но и стимулы, которые метрика задаёт модели.
Метод. Корпус содержит 25,1 часа аудиовизуальных и 22 часа аудиозаписей: 10 173 и 8392 клипа соответственно. Для каждой модальности открытая обучающая часть включает десять часов экспертной разметки и дополнительные псевдометки учителя; закрытые тесты содержат 2372 видео- и 1094 аудиоклипа. Экспертные записи независимо оценивают минимум три подготовленных человека с временными интервалами и уверенностью. Аудиозадача включает шесть сигналов, видеозадача десять; вовлечённость оценивается отдельной трёхклассовой macro-F1. EW-F1 сопоставляет предсказания и эталонные метки взаимно однозначно внутри клипа, давая зачёт 1 за точное совпадение, 0,66 за соседнюю метку того же кластера и 0,33 за соседний кластер. Оптимизируется отношение суммарного зачёта к массам эталонов и предсказаний по всему корпусу, а не среднее F1 клипов. Лишняя метка учитывается с полной стоимостью.
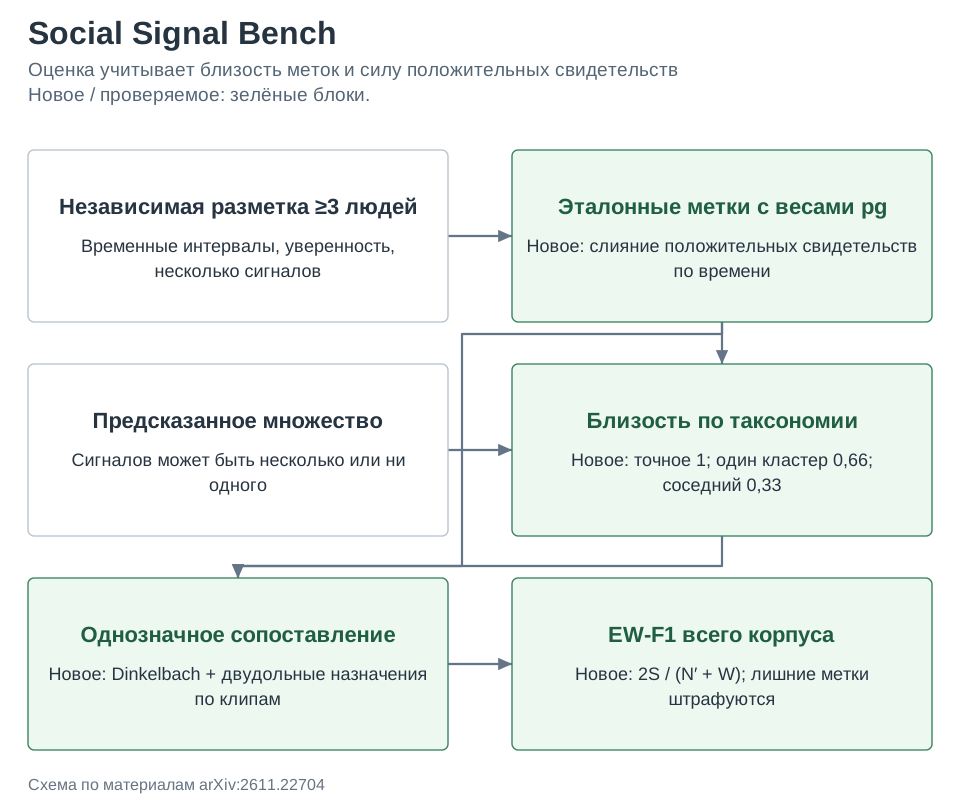
Результаты. После дообучения Qwen2-Audio-7B получает на аудиотесте EW-F1 58,1 против 28,7 без адаптации и 54,0 у Gemini 3.1 Pro; macro-F1 вовлечённости составляет 45,8, то есть не превосходит все альтернативы. На видеотесте адаптированный Qwen2.5-Omni-7B даёт EW-F1 44,0 и macro-F1 вовлечённости 58,4. При смене основной метрики на точную macro-F1 по социальным сигналам видеомодель уже третья, а не первая. Авторы проверяют устойчивость к девяти сочетаниям коэффициентов частичного зачёта и строят интервалы по исходным записям, не по зависимым клипам.
Ограничения. Закрытые тесты и учителя, обученные на дополнительных проприетарных данных, ограничивают независимую воспроизводимость. Вес метки измеряет объём положительных свидетельств, а не долю согласных людей: молчание оценщика отдельно не штрафуется. Таксономия и коэффициенты заданы вручную; метрики разных модальностей нельзя напрямую сравнивать из-за разных наборов сигналов. Это оценка воспринимаемых наблюдателем признаков, не надёжное чтение внутреннего психологического состояния человека.
Фишка из статьи. Рисунок 5 и таблица S5 демонстрируют смену предпочтения метрики на одном клипе. Эталон содержит неуверенность с весом 0,9 и заминку с весом 0,6. Точная F1 предпочитает умолчать о первом сигнале, тогда как EW-F1 допускает полезную близкую гипотезу; выдуманная посторонняя метка всё равно штрафуется.
| Ответ модели | Точная F1 | EW-F1 |
|---|---|---|
| Обе эталонные метки | 1,000 | 1,000 |
| Замешательство вместо неуверенности + заминка | 0,500 | 0,796 |
| Только заминка | 0,667 | 0,571 |
| Заминка + посторонняя скука | 0,500 | 0,387 |
Как это читать: частичный зачёт здесь не разрешает перечислять все возможные эмоции. Однозначное сопоставление и полная стоимость лишних меток препятствуют этому. Но конкретное предпочтение близкой ошибки отражает выбранную таксономию; его нужно отдельно обосновывать для практической задачи и языка.
Источник. Оригинальное название: Social Signal Bench: Evidence-Weighted Evaluation of Co-occurring Social Signals in Video and Audio. arXiv:2611.22704; полный текст PDF.