BaME: генеративное улучшение речи в mel-пространстве с учётом фазы
Mel-представление обычно связывают с потерей фазы и недостаточной точностью восстановления, но BaME использует его как удобное пространство генеративного улучшения речи. Авторы объединяют обработку mel-подполос, смысловые признаки и вокодер с двумя фазовыми опорами. Важная деталь: фаза исходного сигнала помогает при шуме, но может ухудшать воспринимаемое качество при реверберации, поэтому её не стоит сохранять безусловно.
Метод. SaT получает искажённый mel-спектр, текущее состояние генеративного потока и очищенные признаки DeWavLM. Низкоранговые проекции и обработка подполос сочетают BiGRU по частотным группам с вниманием по времени; выход задаётся фильтрующей и уточняющей ветвями. После обучения согласованию потока OS-FPA подстраивает одноступенчатую генерацию совместными потерями восприятия и точности: одни смысловые потери способны вносить артефакты. Вокодер DegVoC начинает с амплитуды, полученной псевдообращением mel-фильтров, и либо нулевой, либо наблюдаемой искажённой фазы. QDV строит две целые звуковые версии и выбирает одну по SCOREQ. Это не смешивание фаз по кадрам и не VAE-кодек: mel здесь является промежуточным представлением, без заданного битрейта сжатия.
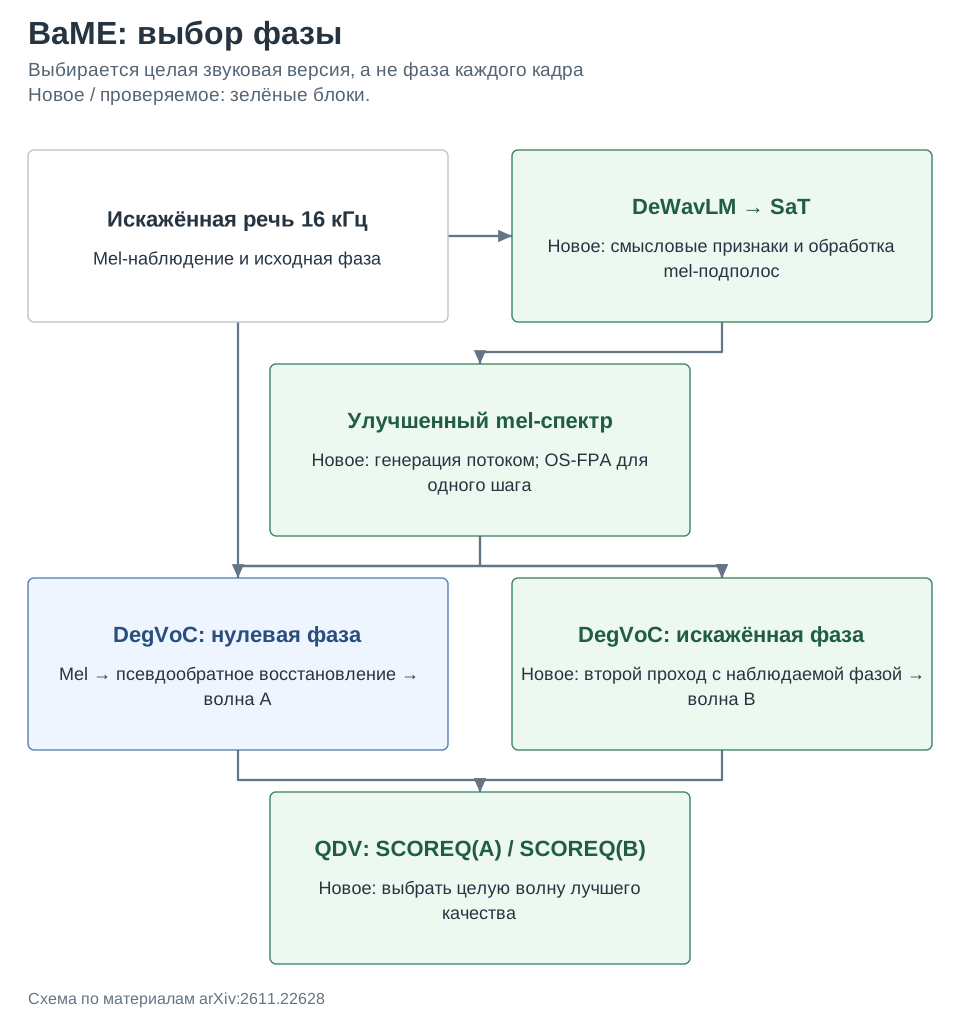
Результаты. На сложном тесте URGENT 2025 BaME получает PESQ 2,259, eSTOI 0,739, CER 12,584%, DNSMOS-OVRL 3,336 и UTMOS 3,293. Это не лидерство по всем мерам: например, первая система конкурса имеет PESQ 2,95 и eSTOI 0,86, но ниже по двум указанным безэталонным оценкам. SaT содержит 9,67 млн параметров, однако вся система с DeWavLM — 332,4 млн и 45,5 GMAC/с. Измеренный RTF составляет 0,85 на Xeon Platinum 8336C и около 0,025 на A100; эти числа описывают конкретную реализацию, а не задержку начала выдачи речи.
Ограничения. Глобальное внимание по времени и полная обработка записи не позволяют из RTF вывести потоковый режим. QDV требует дополнительного прохода вокодера и двух оценок качества; для SCOREQ добавка составляет 19,4 GMAC/с. Выбор по безэталонной метрике может наследовать её предпочтения. Обучение использует 600 часов отобранной чистой речи и широкий набор искусственных искажений; сопоставимость затрат с маленькими специализированными подавителями шума ограничена.
Фишка из статьи. Таблицы V–VI дают полезный отрицательный результат: фазовая опора может улучшить PESQ и одновременно ухудшить другую важную характеристику. Ниже приведены две крайние опоры до автоматического выбора, на DNS-Challenge 2020. Это эксперимент с фазой вокодера, а не сравнение разных систем целиком.
| Условие и фазовая опора | PESQ | UTMOS | WER, % |
|---|---|---|---|
| Шум, нулевая | 3,031 | 4,004 | 1,783 |
| Шум, искажённая | 3,345 | 4,110 | 1,984 |
| Шум + реверберация, нулевая | 2,228 | 3,932 | 6,680 |
| Шум + реверберация, искажённая | 2,301 | 3,479 | 6,755 |
Как это читать: наблюдаемая фаза не является просто «бесплатной полезной информацией». При реверберации UTMOS падает с 3,932 до 3,479, хотя PESQ растёт. SCOREQ выбирает искажённую опору для 98% шумовых записей, но лишь для 16% записей с реверберацией: полезность априорной информации зависит от вида повреждения.
Источник. Оригинальное название: Back to Mel: Learning to Bridge Fidelity and Perception in Generative Speech Enhancement. arXiv:2611.22628; полный текст PDF.