Распознавание и атрибуция перекрывающейся речи с GRPO при неизвестном числе говорящих
Речевая языковая модель ошибается на смесях не только в словах: она может неверно посчитать участников и затем последовательно приписывать текст не тем людям. Авторы сначала учат Qwen2.5-Omni-7B выдавать число говорящих и структурированную расшифровку, а затем используют GRPO с отдельными ограничениями на число людей, текст и время. Самый показательный результат связан с наградой за подсчёт участников, а не с общей декларацией о «рассуждении».
Метод. LoRA добавляют в линейные слои звукового кодировщика, межмодального проектора и языковой модели. После начального обучения с учителем целевой ответ содержит короткий префикс с числом говорящих и XML-сегменты с личностью, началом, концом и текстом. Перестановки меток говорящих при обучении случайны, чтобы не закреплять произвольный порядок. На втором этапе для смеси получают восемь вариантов ответа и сравнивают их пятью равно взвешенными наградами: правильное число людей, ошибка слов с перебором перестановок, ошибка временных границ, штраф за длинные серии вставок/замен и структурная согласованность. GRPO использует относительные награды внутри группы и KL-ограничение к опорной модели. Эталонные слова и границы нужны только для обучения, а не при применении.
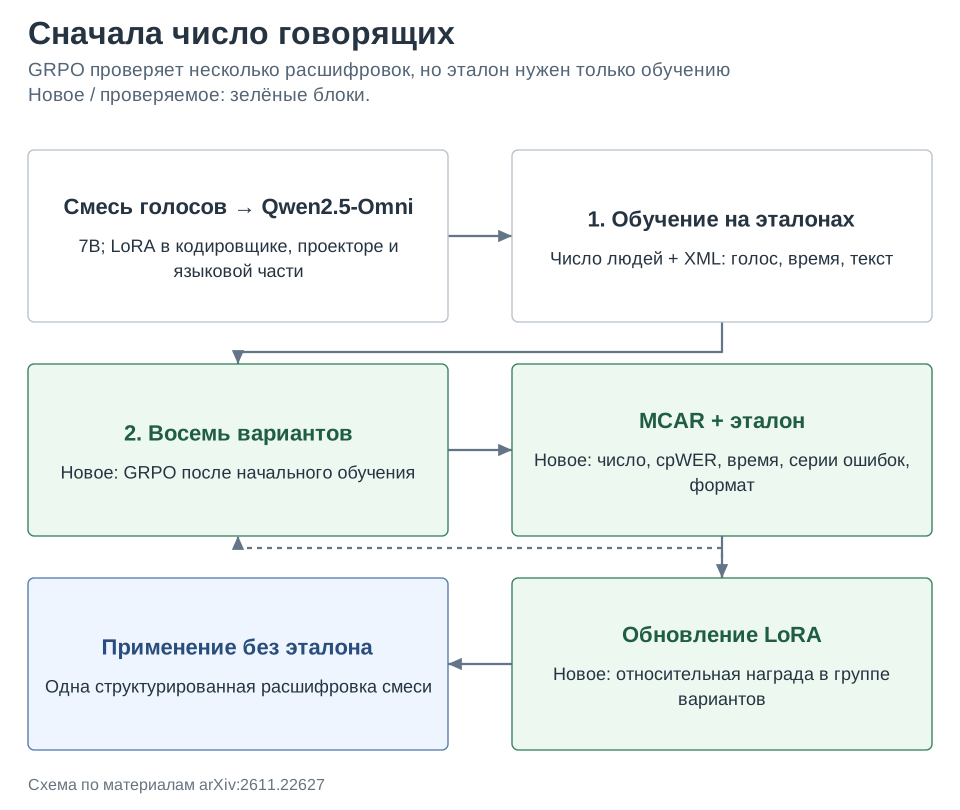
Результаты. На Dynamic-Mix, где смешаны случаи с двумя и тремя говорящими, обычное обучение с префиксом даёт cpWER 20,17%, WDER 3,73% и точность числа людей 90,06%. После GRPO это 9,24%, 1,12% и 99,72%; средняя ошибка временных границ уменьшается с 0,15 до 0,08 с. На Libri2Mix получены cpWER 4,45% и WDER 0,48%, на Libri3Mix — 14,52% и 1,95%. WDER здесь оценивает неверного говорящего у правильно распознанных слов и не равен обычному DER по длительности. Лучший результат из всех сравниваемых методов достигнут не на каждой отдельной метрике.
Ограничения. Проверка ограничена короткими искусственными смесями двух или трёх голосов. Реальные длинные встречи AMI и AliMeeting обозначены как дальнейшая работа. Нет измеренных RTF, задержки и устойчивости при большем числе людей; восемь обучающих вариантов повышают стоимость обучения. Сравнивать строки с WDER и строки с временным DER в общей таблице статьи напрямую некорректно.
Фишка из статьи. Удаление награды за число участников почти удваивает cpWER, хотя формат и остальные награды остаются. Таблица 3 также отделяет последствия длинных серий ошибок от чисто структурных ограничений. Это содержательная проверка того, какую часть поведения действительно закрепляет обучение.
| Награды на Dynamic-Mix | cpWER, % | WDER, % | Верное число людей, % |
|---|---|---|---|
| Все пять | 9,24 | 1,12 | 99,72 |
| Без награды за число | 18,02 | 3,13 | 91,67 |
| Без штрафа за серии ошибок | 11,84 | 1,32 | 98,50 |
| Без перебора перестановок | 16,56 | 2,84 | 99,17 |
Как это читать: считать участников и уметь сопоставлять их произвольные метки — разные требования. Почти правильное число людей без перестановочно-инвариантной награды ещё не даёт хорошей расшифровки. Результат поддерживает конкретные ограничения для этой задачи, а не универсальную пользу длинной цепочки рассуждений.
Источник. Оригинальное название: Beyond Mimicry: Constrained Exploration with GRPO for Joint Multi-Talker ASR and Diarization under Unknown Speaker Counts. arXiv:2611.22627; полный текст PDF.