Персональное восстановление речи после низкоскоростного кодирования с помощью векторов диктора
У декодированной телефонной речи можно восстановить не только верхние частоты, но и характерные особенности голоса. Авторы добавляют в причинный UBGAN заранее вычисленный вектор диктора и сравнивают это с выбором отдельной сети для группы похожих голосов. Интересен отрицательный результат: четыре специализированные сети здесь уступают одной сети с небольшим персональным условием.
Метод. AMR-NB работает на 4,75 кбит/с и выдаёт речь 8 кГц; генератор восстанавливает 16 кГц, имея право менять и уже существующую низкочастотную часть. PQMF разбивает вход на две полосы, а выход синтезируется из четырёх. Замороженный ECAPA-TDNN, обученный на VoxCeleb1/2, извлекает 192-мерный вектор из отдельной чистой записи того же человека. Проекция 1×1 согласует его с mel-условием, после чего вектор повторяется по времени и складывается с акустическими признаками перед блоками U-Net. При обучении усредняют записи одного диктора, при проверке используют другую одиночную запись, не текущую цель. Альтернатива — четыре кластера векторов и четыре независимо обученных генератора; ближайший кластер выбирается по косинусному сходству. Это восстановитель после существующего кодека, а не новый формат сжатия или передача вектора внутри битового потока.
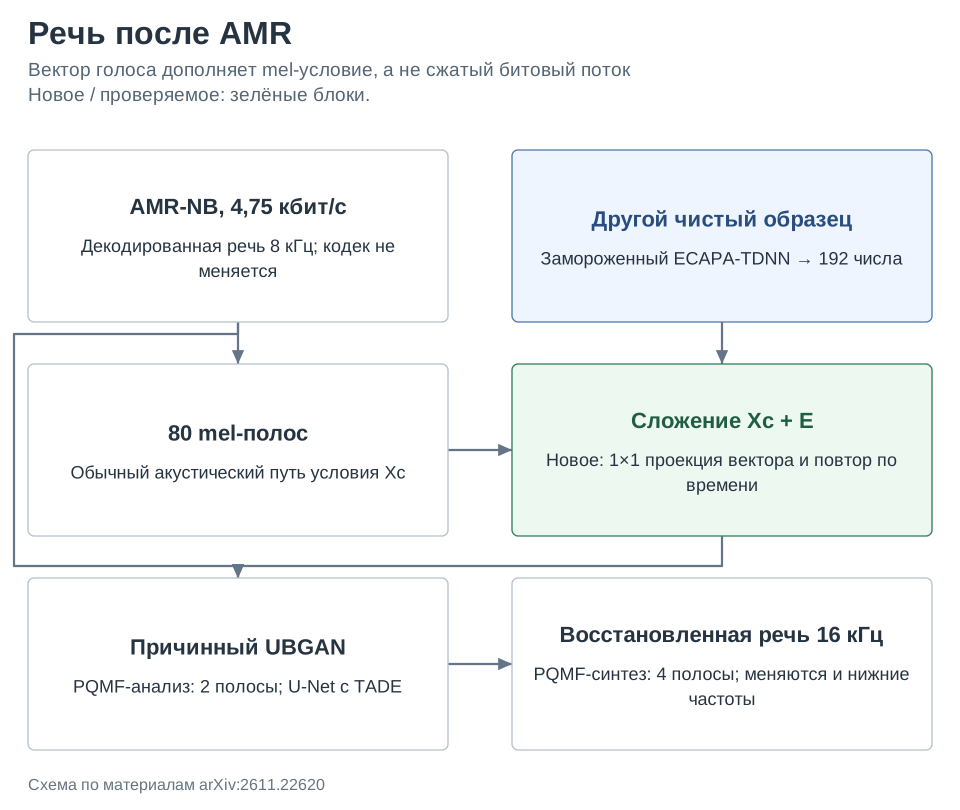
Результаты. На VCTK обучение охватывает 89 дикторов, проверка обобщения — десять ранее не встречавшихся. Добавление вектора меняет размер UBGAN с 309 до 318 тыс. параметров при практически прежних 0,253 GMAC на секунду звука. Для знакомых голосов PESQ растёт с 2,36 до 2,47, ViSQOL с 2,80 до 2,92; для новых — с 2,28 до 2,34 и с 2,92 до 2,97. Парные проверки по дикторам подтверждают прирост двух метрик, но не LSD. Более высокое абсолютное ViSQOL на новых голосах само по себе не означает лучшего обобщения: тексты и записи различаются.
Ограничения. Персонализация требует чистого образца правильного человека, который в обычном звонке может быть недоступен. Стоимость извлечения ECAPA вынесена в отдельную подготовку и не включена в основной проход. Из малого числа операций нельзя вывести фактическую задержку телефона: измеренных RTF и задержки на целевом устройстве здесь нет. Проверены один кодек, один режим скорости и ограниченный набор голосов.
Фишка из статьи. В таблице 1 видно, что увеличение банка моделей не заменяет удачную точку введения персональных признаков. Ни кластеризация, ни её сочетание с векторным условием не улучшают причинный UBGAN так же устойчиво, как простое сложение условий. В таблице ниже приведены средние PESQ; стоимость хранения относится к генераторам, без ECAPA.
| Вариант UBGAN | Параметры генераторов | PESQ: знакомые | PESQ: новые |
|---|---|---|---|
| Без персонализации | 309 тыс. | 2,36 | 2,28 |
| Вектор диктора | 318 тыс. | 2,47 | 2,34 |
| Выбор кластера | 4 × 309 тыс. | 2,33 | 2,22 |
| Кластер + вектор | 4 × 318 тыс. | 2,36 | 2,24 |
Как это читать: новые голоса особенно страдают от узкой специализации кластеров. Практический выигрыш даёт не число сетей, а доступность персонального признака в акустическом пути. Для некаузального HiFi-GAN+ авторы получают другой порядок вариантов, поэтому вывод не универсален для любой архитектуры.
Источник. Оригинальное название: Personalized Causal Low-Bitrate Coded Speech Restoration with Speaker Embeddings. arXiv:2611.22620; полный текст PDF.