PACD: выбор ответа с учётом происхождения признаков против межмодальных галлюцинаций
Согласие звуковой, зрительной и совместной ветвей ещё не делает ответ мультимодальной модели правильным: все три могут повторить одну ошибку. PACD различает потерю полезного ответа одной модальности при объединении и ошибочное единодушие. Для этих случаев используются разные правила выбора, а основания альтернативы ищут во внутренних вкладах модальностей по слоям без дообучения модели.
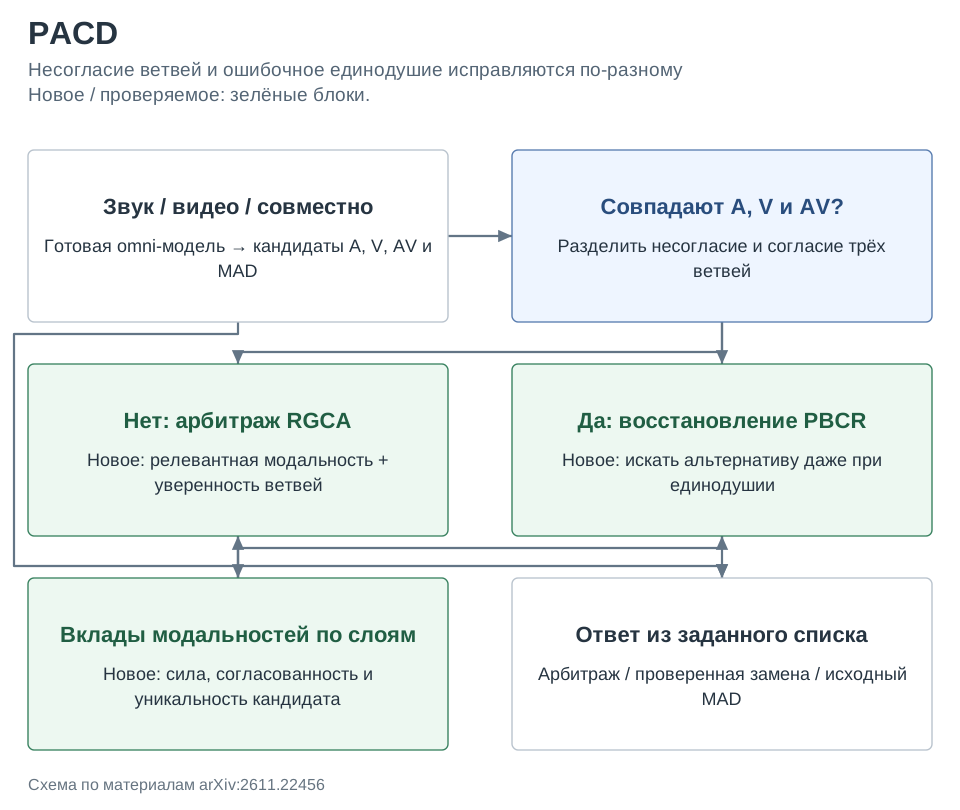
Метод. Модель получает вопрос с заданными вариантами и оценивает ответы при звуковом, зрительном, совместном и текстовом условиях; сохраняется также контрастивный ответ MAD. Если три содержательные ветви расходятся, RGCA выбирает наиболее релевантную вопросу модальность и проверяет её решение с учётом уверенности и альтернативы. Альтернативу строят, выделяя вклады звуковых и зрительных токенов во внимании совместной ветви и проецируя их в пространство логитов ответа. Если же ветви согласны, PBCR допускает замену только при достаточных согласованности поддержки по слоям, её силе, уникальности кандидата и отсутствии сильного противоречия уверенности. Иначе сохраняется MAD. Эти вклады служат внутренними признаками происхождения решения, но не объявляются точными причинными атрибуциями.
Результаты. Проверены VideoLLaMA2-AV, OmniVinci и Qwen2.5-Omni размером 3B и 7B. На OmniVinci итоговая точность CMM растёт с 82,4 до 87,4%, AVHBench — с 71,1 до 78,8%, SVHalluc — с 50,9 до 63,7%. Для Qwen2.5-Omni-7B на CMM прирост составляет 18,9 процентного пункта, с 68,4 до 87,3%; это не 18,9% относительного роста. На VideoLLaMA2-AV-7B и A100 задержка CMM равна 1,45 с против 1,41 с у MAD при одинаковых 20,7 ГБ пиковой памяти. Без обучения не означает без дополнительных вычислений или доступа к внутренним состояниям.
Ограничения. Результаты относятся к выбору из заданных ответов, включая бинарные вопросы; свободная генерация расшифровок и речь на выходе не оценивались. Точность временных отношений на SVHalluc остаётся заметно ниже семантической. Метод использует несколько порогов и модельно-зависимое считывание слоёв; измеренная задержка не гарантирует такую же стоимость на другой архитектуре, длине видео или потоковом интерфейсе.
Фишка из статьи. В таблице 3 два механизма оказываются не взаимозаменяемыми. Арбитраж при несогласии почти не исправляет семантическую часть SVHalluc, зато восстановление согласия даёт большой сдвиг именно там. Простой выбор самой релевантной модальности упускает этот класс ошибок.
| OmniVinci: вариант | CMM, % | SVHalluc: семантика, % | SVHalluc: всего, % |
|---|---|---|---|
| Маршрутизация по релевантности | 83,5 | 59,7 | 53,6 |
| RGCA: только арбитраж | 86,9 | 59,8 | 54,0 |
| Маршрутизация + PBCR | 84,0 | 75,0 | 62,9 |
| Полный PACD | 87,4 | 75,7 | 63,7 |
Как это читать: улучшать взвешивание модальностей недостаточно, если ошибка уже общая. На выделенных 806 случаях ошибочного согласия PACD исправляет 570, а MAD лишь 23. Это результат на заранее выделенном подмножестве, не универсальная доля устранённых галлюцинаций произвольного диалога.
Источник. Оригинальное название: PACD: Provenance-Aware Consensus Decoding for Mitigating Cross-Modal Hallucinations in Omnimodal Large Language Models. arXiv:2611.22456; полный текст PDF.