VoxMel: синтез речи с разложением Haar вместо обучаемого акустического токенизатора
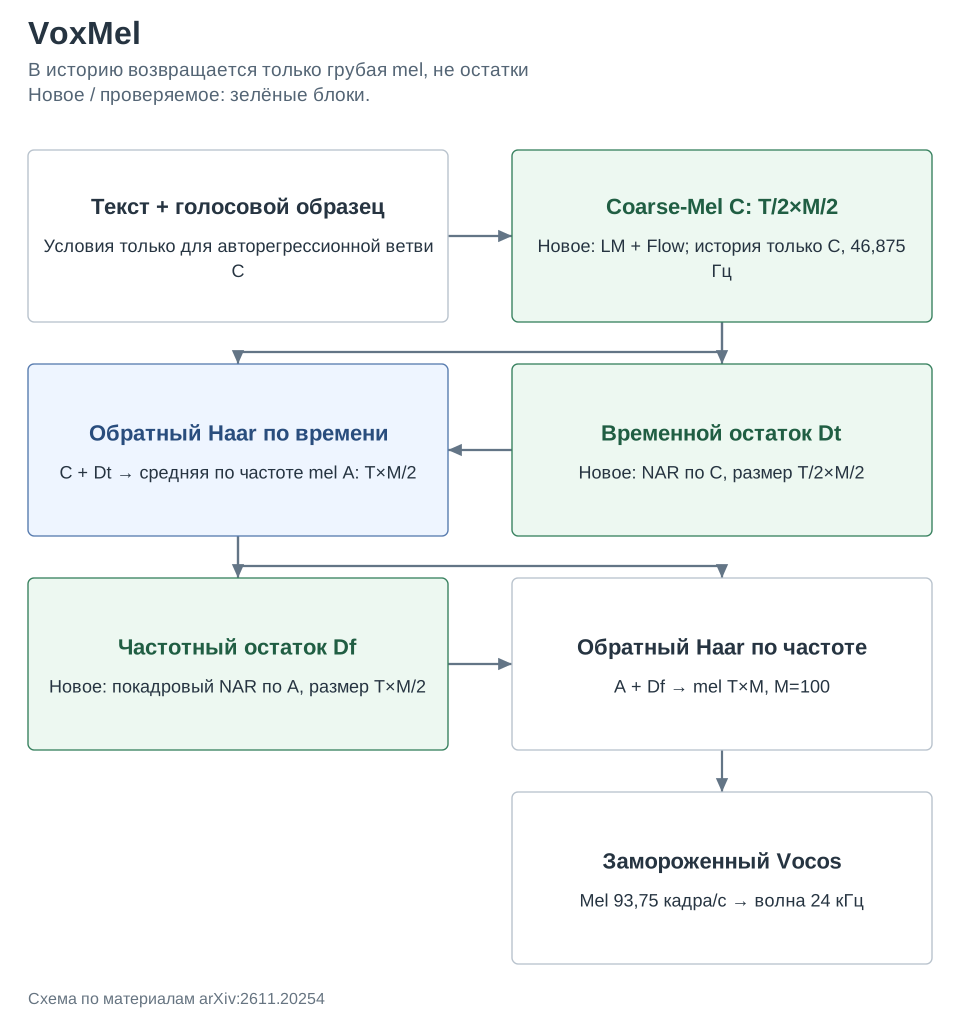
VoxMel возвращает авторегрессионный синтез к mel-спектрограмме, но не заставляет языковую модель последовательно предсказывать все её детали. Фиксированное обратимое разложение Haar выделяет грубую составляющую, а два остатка восстанавливаются отдельно. Главный ход — исключить оба остатка из авторегрессионной истории, чтобы ошибки мелких деталей не становились входом следующих шагов.
Метод. Сначала соседние частотные каналы делятся на среднее A и частотный остаток Df; затем соседние кадры A — на Coarse-Mel C и временной остаток Dt. Для исходной сетки T×M размеры C и Dt равны T/2×M/2, Df — T×M/2. Языковая основа с головой flow matching генерирует только C по тексту и голосовому образцу. Двунаправленная неавторегрессионная ступень предсказывает Dt, обратный Haar восстанавливает A, после чего покадровая ступень предсказывает Df. Ступени последовательны между собой, хотя позиции внутри них обрабатываются параллельно. Обратное преобразование и замороженный Vocos дают звук. При 24 кГц и шаге 256 mel имеет 93,75 кадра/с, C — 46,875; это непрерывное представление, не дискретный кодек и не заявленный битрейт. Haar здесь фиксирован, а не адаптивен.
Результаты. Модель, называемая 0.6B, по таблице модулей содержит 690,1 млн параметров без 13,6 млн Vocos и обучена на 100 тыс. часов Emilia. На Seed-TTS test-en получены WER 1,51% и SIM 0,738, на test-zh CER 1,29% и SIM 0,755. GRPO с замороженными головами и остаточными ступенями улучшает их до 1,15%/0,753 и 1,17%/0,776. Четырёхшаговая дистилляция сокращает вызовы грубой головы с 96 до 4 на кадр, но английский WER растёт до 1,49%, SIM падает до 0,693. Это сокращение NFE одной головы, не измеренное ускорение всей системы в 24 раза.
Ограничения. Проверены короткие английские и китайские реплики; длинный синтез, диалоги, пение и общие звуки не исследованы. Временная остаточная ступень двунаправленная, поэтому потоковая задержка не следует из темпа C. Точное обращение Haar сохраняет mel-коэффициенты, но не делает преобразование звука в mel без потерь. Основные сравнения с другими моделями различаются данными и размером; сопоставление с VAE в DiTAR-подобной архитектуре также не полностью согласовано.
Фишка из статьи. Абляция таблицы 5 на малой модели 0.15B показывает, что простое сокращение временного темпа не объясняет результат. Только частотный или только временной разрыв рекурсии значительно хуже совместного. Коэффициенты остатка не отбрасываются: меняется то, какие из них возвращаются в историю.
| Рекуррентная история, 0.15B | Темп, Гц (округлённо) | WER test-en, % | SIM |
|---|---|---|---|
| Полная mel, без разложения | 94 | 30,35 | 0,493 |
| Без частотного остатка | 94 | 6,64 | 0,621 |
| Без временного остатка | 47 | 11,41 | 0,552 |
| Без обоих остатков | 47 | 1,90 | 0,667 |
Как это читать: это сильный внутримодельный аргумент в пользу структуры обратной связи, но не доказательство превосходства любого вейвлета над любым VAE. Другие семейства и глубины вейвлетного разложения авторы не проверяли.
Источник. Оригинальное название: VoxMel TTS Technical Report. arXiv:2611.20254; полный текст PDF.