Ускорение Nemotron 3.5 Transcribe: выбор размера GPU-ядра по текущей нагрузке
Для большого распознавателя объединить как можно больше операций в одно GPU-ядро полезно не при любой нагрузке. Авторы строят сервер Nemotron 3.5 Transcribe, который на каждом проходе выбирает между постоянным мегаядром и цепочкой специализированных объединённых ядер. Суть не в новых весах речевой модели, а в согласовании гранулярности вычислений с меняющимися размерами пакета, предварительной обработкой и проверкой черновых токенов.
Метод. Распознаватель объединяет акустический кодировщик, Sortformer и гибридную Mamba/Transformer/MoE-основу; верификация черновиков требует корректного восстановления состояний Mamba. Пороговые точки измеряют заранее: акустический кодировщик и Sortformer переключаются около 384 входных токенов, MoE — около 448 строк шага декодирования. Для небольших проходов выгодны мегаядра с малым числом запусков, для крупных — специализированные GEMM. Строки новых запросов и проверки продолжающихся запросов объединяются, чтобы читать экспертные веса один раз. Черновая MTP-голова и выбор токенов остаются на GPU; временные CTC-подсказки помогают спекуляции. Это численные пороги конкретной реализации, а не универсальные константы речевого распознавания.
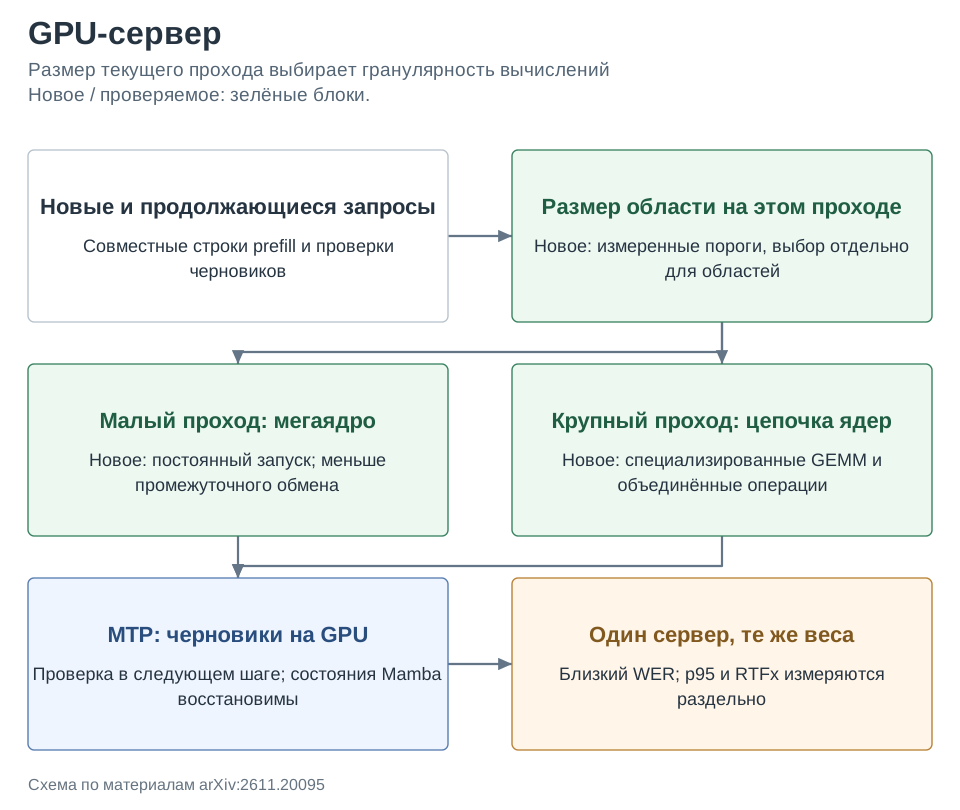
Результаты. На английском Bias, 4820 записей / 15,36 ч, точный по принятому допуску режим достигает RTFx 4345 на H100 SXM и 6367 на B200: столько секунд аудио обрабатывается за секунду суммарного времени. Это в 1,39 и 1,64 раза выше соответствующего пика сравниваемого vLLM. При бюджете p95 завершения запроса 400 мс обслуживаются 64 одновременных запроса на H100 и 128 на B200 против 8 и 16 у vLLM. На B200 пиковая память 56,0 против 73,3 GiB, WER 1,92–1,93% против 1,89–1,91%. На LibriSpeech test-clean+other сохраняется ускорение, но RTFx и WER отличаются от Bias.
Ограничения. RTFx не равен задержке одной реплики или времени после обнаружения её конца. Режим сохраняет близкий WER, но не побитовый результат: состав пакета меняет округление FP8. CPU-хосты H100 SXM и NVL различаются, поэтому межхостовые выводы ограничены. Пороги выбраны офлайн; иной поток запросов и маршрутизация экспертов могут сдвинуть их. Дополнительные переключатели пропуска экспертов и слоёв дают ещё 13–16% на B200, но поднимают WER примерно до 3,44–3,48%: эти результаты нельзя смешивать с основным режимом.
Фишка из статьи. Раздел 7.2 содержит редкий полезный отрицательный результат: уменьшение объёма весов через INT4 оказалось медленнее FP8, а ускорение только декодирующих шагов почти не изменило итоговую пропускную способность. Оптимизировать следует критический путь всего сервера, а не самый эффектный микротест.
| Попытка оптимизации | Измерение | Что ограничило эффект |
|---|---|---|
| INT4 эксперты вместо FP8 | FC1: 400–630 против 230–245 мкс | Более медленные смешанные GEMM |
| Только decode-мегаядра в vLLM | Шаги быстрее на 7,6–16,4%; итог ×0,9965 | В них лишь 0,3% токенов |
| Постоянное мегаядро кодировщика, 1024 токена | 7,66 против 6,05 мс | Крупный проход лучше специализированных ядер |
Как это читать: меньше байтов не гарантирует меньше времени, а ускоренная ветвь не помогает, если завершение определяет другая. Эти числа относятся к разным диагностическим опытам статьи, не складываются в общий процент ускорения.
Источник. Оригинальное название: High-Throughput Serving of Nemotron 3.5 Transcribe with Regime-Aware Megakernels and Kernel Fusion. arXiv:2611.20095; полный текст PDF.