Decode Early, Verify Late: потоковые черновики для точного финального распознавания
Офлайн-распознаватель может выдавать промежуточные гипотезы ещё во время речи, не обязуясь навсегда закреплять их ранние ошибки. DEVL использует последнюю гипотезу как черновик, а после конца реплики проверяет её по полному звуку одним проходом и дописывает только неподтверждённый хвост. Это способ перенести вычисления до момента ожидания окончательного текста, а не новая обученная речевая модель.
Метод. Для Qwen3-ASR аудио разбивается на фиксированные блоки от начала потока, независимо от клиентских пакетов, и допустимые блоки кешируются. Контрольные точки копируют состояние, проверяют прежний черновик и продолжают его; окончательная проверка объединена с обработкой хвоста аудио. До первого несовпадения префикс совпадает с жадным декодированием; после отката продолжается обычная генерация. Если новые данные меняют нормализацию или признаки, кеш пересчитывается. Очередь отдаёт приоритет финалам, а черновики используют остаток GPU-времени. Для Whisper и Nemotron с кодировщиком полной записи звук в конце кодируется заново; у Nemotron состояние Mamba восстанавливают воспроизведением принятых входов. Гарантия равенства офлайн-выводу требует жадного выбора, детерминированного входа, совпадающих позиций и состояния и точной арифметики.
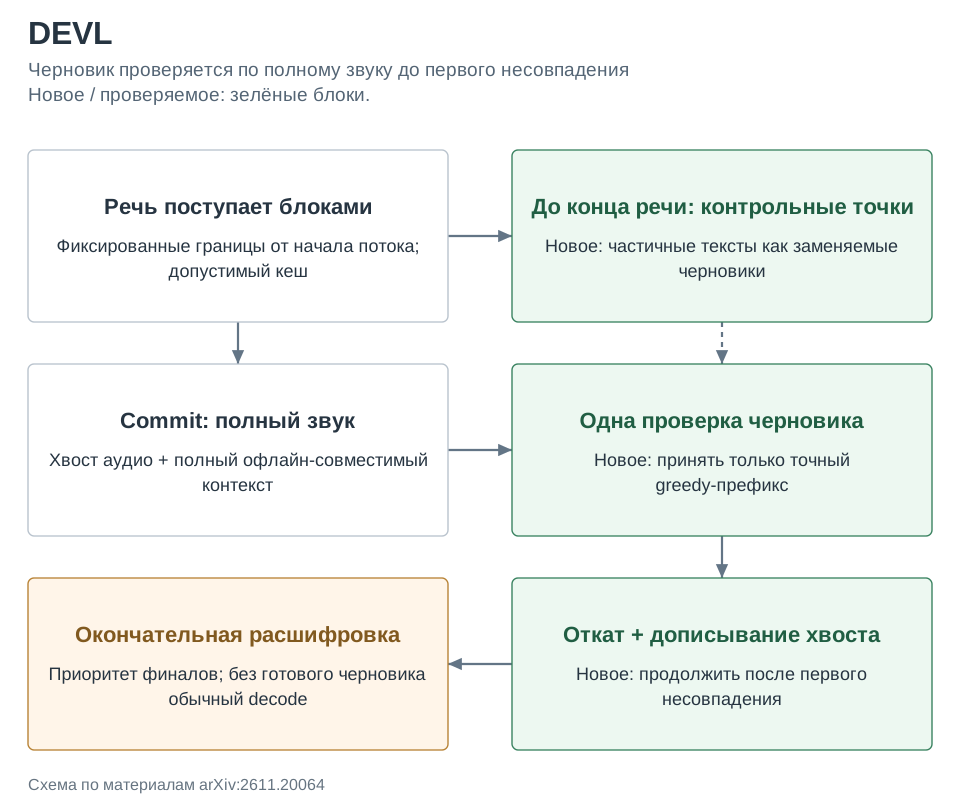
Результаты. В сравнении пяти распознавателей финальные строки совпадают побайтно с их собственным офлайн-режимом в 95–100% случаев, WER отличается не более чем на 0,13 процентного пункта. Для Qwen3-ASR-1.7B на одном A100 медиана времени от commit до финала составляет 22–26 мс при нагрузке до 64 потоков. Порог p99 100 мс выдерживается до 80 потоков Pipecat-STT и 64 WildASR. Это клиентский commit вместе с последним пакетом, а не автоматическое определение конца речи. При добавлении 300 или 600 мс тишины экономия относительно того же движка без черновиков остаётся, но само ожидание тишины никуда не исчезает.
Ограничения. Опыты английские; эталоны Pipecat-STT созданы Gemini, не человеком. Округление при пакетных вычислениях нарушает побитовое равенство; разбиение длинных реплик Qwen3-ASR на эпохи также исключено из теоретической гарантии. База без черновиков одновременно отключает эпохи, поэтому главное сравнение смешивает два эффекта; автор отдельно проверяет реплики до 10 с. На большой нагрузке черновики могут перестать окупаться, особенно у тяжёлых моделей. Частичные результаты и их задержка не оптимизированы столь же подробно, как финальные.
Фишка из статьи. В разделе 4.2 видна причина резкого ухудшения при насыщении. Наличие работающего декодирования недостаточно: черновик должен успеть завершиться до commit. Увеличение числа одновременно считающихся контрольных точек возвращает выигрыш, но это уже выбор планировщика.
| Qwen3-ASR, нагрузка / политика | Финалы с готовым черновиком | Медиана TTFS Pipecat, мс |
|---|---|---|
| 64 потока, обычная | Не менее 98% | В диапазоне 22–26 |
| 128 потоков, обычная | 21–29% по двум наборам | 138,5 |
| 128 потоков, 16 контрольных точек | Не менее 95% | 38,2 |
| 128 потоков, 32 контрольные точки | Не менее 95% | 32,6 |
Как это читать: это не фиксированное ускорение алгоритма при любой нагрузке. Польза определяется своевременностью черновика и ресурсами очереди; TTFS измеряет только хвост после commit, а не всю реакцию голосового агента.
Источник. Оригинальное название: Decode Early, Verify Late: Streaming Offline Speech Recognizers Without Accuracy Loss. arXiv:2611.20064; полный текст PDF.