ProTTS: автоматическое обнаружение смыслового выделения слов внутри синтезатора речи
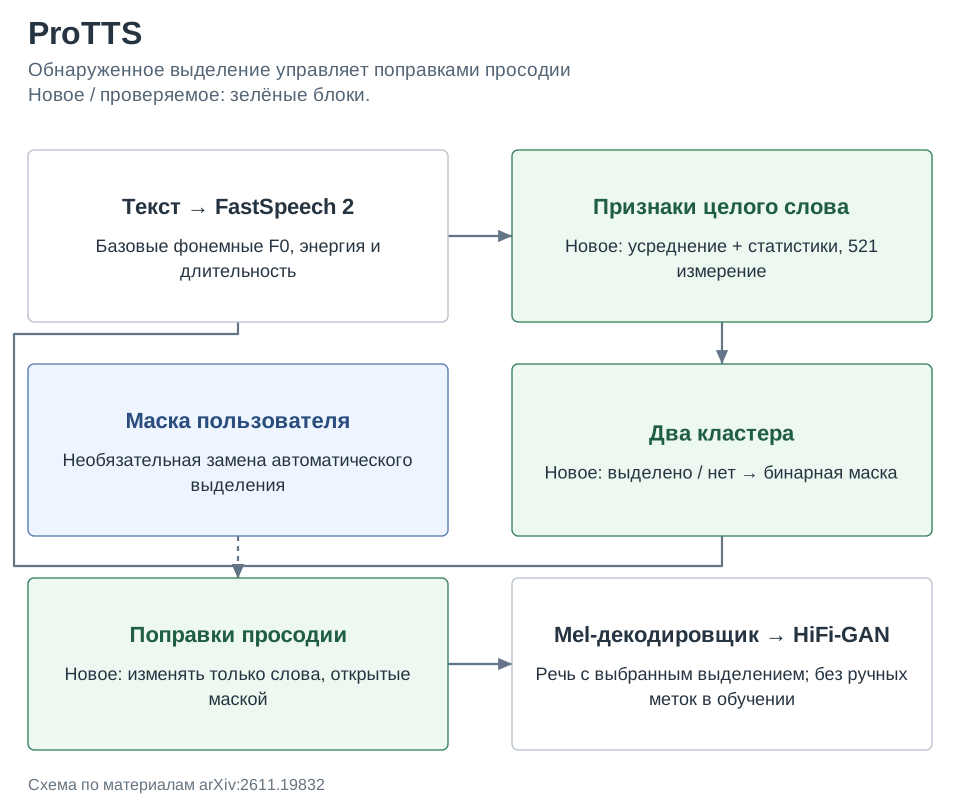
ProTTS пытается определить, какие слова выделять интонацией, используя собственные предсказания высоты тона, энергии и длительности FastSpeech 2. Затем найденное выделение управляет поправками этих же признаков. Речь идёт о просодической заметности целого слова в предложении, а не об определении ударного слога в словаре; пользователь может заменить автоматическую маску своей.
Метод. Фонемные признаки высоты тона и энергии усредняются внутри слова, а длительности описываются статистиками, позицией и количеством фонем: получается 521-мерный вектор. Кластеризующая голова с двумя центрами и распределением Стьюдента разделяет слова на выделенные и невыделенные. Цель KL обостряет назначения, балансировочная цель препятствует схлопыванию в один кластер; кластер с большей нормой центра считается выделенным. Маска пропускает обучаемые поправки F0, энергии и длительности только для выбранных слов. После эпохи обновляются псевдометки и целевые поправки; оптимизируются синтез и кластеризация. Для начального размещения центров лучше оказались длительность и F0 без энергии, хотя дальнейшие признаки включают все три компонента.
Результаты. При обучении в том же домене на ISLE F1 равна 0,839 для немецких и 0,861 для итальянских носителей, говорящих по-английски; каскад без совместной оптимизации получает 0,803 и 0,831. На Tatoeba модель, обученная на LibriTTS, даёт 0,933 F1. В слуховом тесте с 35 участниками естественность составляет 3,96±0,11 против 3,12±0,14 у FastSpeech 2, а предпочтение — 83,5%. Это сравнение с базовым синтезатором, не с современными крупными моделями. Заявление о превосходстве всех размеченных методов слишком сильное: в таблице 1 некоторые итальянские результаты равны 0,87, выше 0,861.
Ограничения. Бинарная маска упрощает непрерывную просодическую заметность. Акустические признаки не определяют однозначно намерение говорящего, контраст и контекст беседы; усреднение по слову размывает локальное выделение слога. Эксперименты английские, включая только два происхождения неродной речи; перенос на тональные языки и другие архитектуры синтеза не проверен. Предположение о норме центра и балансировка двух кластеров вносят априорные ограничения даже при отсутствии ручных меток.
Фишка из статьи. Таблица 3 отделяет впечатляющую внутридоменную F1 от переноса на неродную речь. Модель, обученная на английских носителях, теряет заметную долю качества на ISLE. Это практический сигнал для систем обучения произношению: отсутствие разметки не отменяет сдвиг распределения.
| Обучающие данные | ISLE GER F1 | ISLE ITA F1 |
|---|---|---|
| ISLE, тот же домен | 0,839 | 0,861 |
| LibriTTS, перенос | 0,781 | 0,752 |
| VCTK, перенос | 0,764 | 0,730 |
Как это читать: высокий результат на Tatoeba и устойчивость к акценту отвечают на разные вопросы. Автоматическое выделение следует проверять на целевой группе говорящих, особенно когда оно используется как обратная связь учащемуся.
Источник. Оригинальное название: ProTTS: End-to-End Prominence-aware Natural and Controllable Text-to-Speech via Automatic Word Stress Discovery. arXiv:2611.19832; полный текст PDF.