Как дообучать выразительный синтез речи без копирования плоской интонации образца
Голосовой образец задаёт не только личность диктора, но и манеру произнесения, поэтому нейтральная подсказка может подавлять эмоцию, которую требует текст. Авторы последовательно учат Qwen3-TTS лучше реагировать на содержание, а затем переносят поведение с выразительной подсказкой в режим слабой нейтральной подсказки. Сильная сторона работы — разбор этапов дообучения; важная цена — частичная потеря сходства голоса.
Метод. Исходная модель — Qwen3-TTS-12Hz-1.7B-Base. Сначала строятся проверенные моделью-судьёй пары предпочтений: сильный синтезатор предлагает выразительную речь, исходная модель — несколько вариантов; фильтруются текстовые ошибки и качество, голоса расширяются через SeedVC. После DPO на 20 тыс. пар для 500 голосов выполняют GSPO с наградой за просодию, UTMOS, точность распознавания и сходство диктора. Финальный OPSD сравнивает распределения полного словаря при одинаковом префиксе: ученик получает слабую подсказку, остановленный по градиенту учитель — сильную. Минимизируется JSD; при применении выразительный образец учителя не нужен. Это обучение условному поведению, а не добавление ещё одного распознавателя в тракт синтеза.
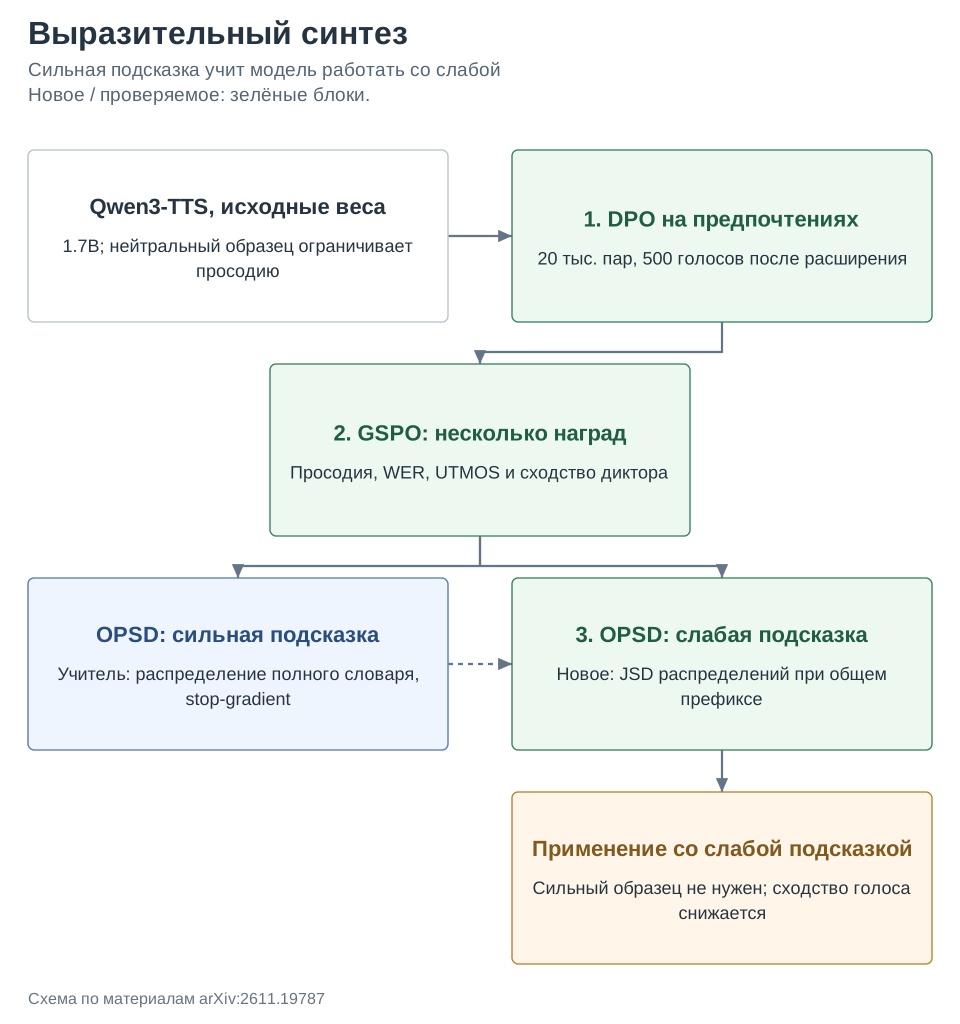
Результаты. В основном усреднённом тесте эмоция повышается с 18,5 у базы до 66,8 после DPO, 69,6 после GSPO и 81,2 после OPSD; паралингвистические элементы — с 38,4 до 57,6, 66,3 и 73,9. Но английский WER Seed-TTS меняется с 1,23% до 1,55%, а SIM с 0,72 до 0,59. Субъективная просодическая оценка PMOS растёт с 3,45 до 3,95, сходство SMOS снижается с 4,00 до 3,80. В парном тесте со слабой подсказкой OPSD предпочитают базе в 67,4% сравнений, базу — в 25,7%; остальные ответы являются ничьими.
Ограничения. Много решений зависит от закрытых Gemini-судей и синтетических предпочтений. Парный слуховой эксперимент включает 20 слушателей, но лишь три голоса; это не широкая проверка всех дикторов. Основные таблицы и одноголосые внутридоменные абляции имеют разные шкалы, их результаты не следует объединять. Расширение голосов в отдельных вариантах сопровождается изменением объёма и построения данных; не весь выигрыш можно приписать только разнообразию. Улучшение выразительности не доказывает сохранения личности или произношения.
Фишка из статьи. Таблица 1 позволяет увидеть траекторию компромисса, а не только максимальную эмоциональность. GSPO частично исправляет ухудшение сходства после DPO, тогда как OPSD снова сдвигает решение к выразительности. Это полезнее единственного итогового рейтинга.
| Этап | Эмоция ↑ | Паралингвистика ↑ | SIM, английский ↑ | SMOS ↑ |
|---|---|---|---|---|
| База | 18,5 | 38,4 | 0,72 | 4,00 |
| DPO, 20 тыс. / 500 голосов | 66,8 | 57,6 | 0,55 | 3,80 |
| GSPO | 69,6 | 66,3 | 0,62 | 3,95 |
| OPSD | 81,2 | 73,9 | 0,59 | 3,80 |
Как это читать: выбирать этап стоит по задаче. Для актёрского исполнения дополнительная выразительность может оправдать потерю сходства; для персонального голоса такой обмен нельзя считать бесплатным улучшением.
Источник. Оригинальное название: Rethinking Post-Training for Expressive Zero-Shot Text-to-Speech. arXiv:2611.19787; полный текст PDF.