MOUSSE: разделение многоязычной речи с оценкой локальной неопределённости
MOUSSE не считает все моменты смеси одинаково сложными: около вступления голоса и при перекрытии разделитель может ошибаться сильнее. Модель отдельно оценивает масштаб своей локальной ошибки и использует его при генерации. Ценность работы — не только новый англо-корейский тест, но и абляция, показывающая, что изменение обучения помогает больше, чем сам адаптивный режим генерации.
Метод. MuSSeD состоит из 37800 синтетических смесей 514 дикторов, по 2–4 голоса, длительностью 3–15 с. Дикторы между обучением, проверкой и тестом не пересекаются. Для каждого числа голосов выделены 10000/1300/1300 смесей. Перекрытие задаётся между соседними репликами относительно более короткой; при трёх и четырёх голосах это не глобальная доля одновременной речи всей записи. Разделитель SpeechFlow обучается с весами только активных кадров и удвоенным весом около границы активности, окно 15 кадров. Дополнительный Transformer предсказывает положительный масштаб Gaussian NLL по смеси, времени потока и текущему состоянию; предсказание скорости разделителя в этой цели остановлено по градиенту. Для MSE и NLL выбираются перестановки PIT. На 16 шагах Euler масштаб, усреднённый по mel-каналам и ограниченный сверху 2, управляет усилением CFG.
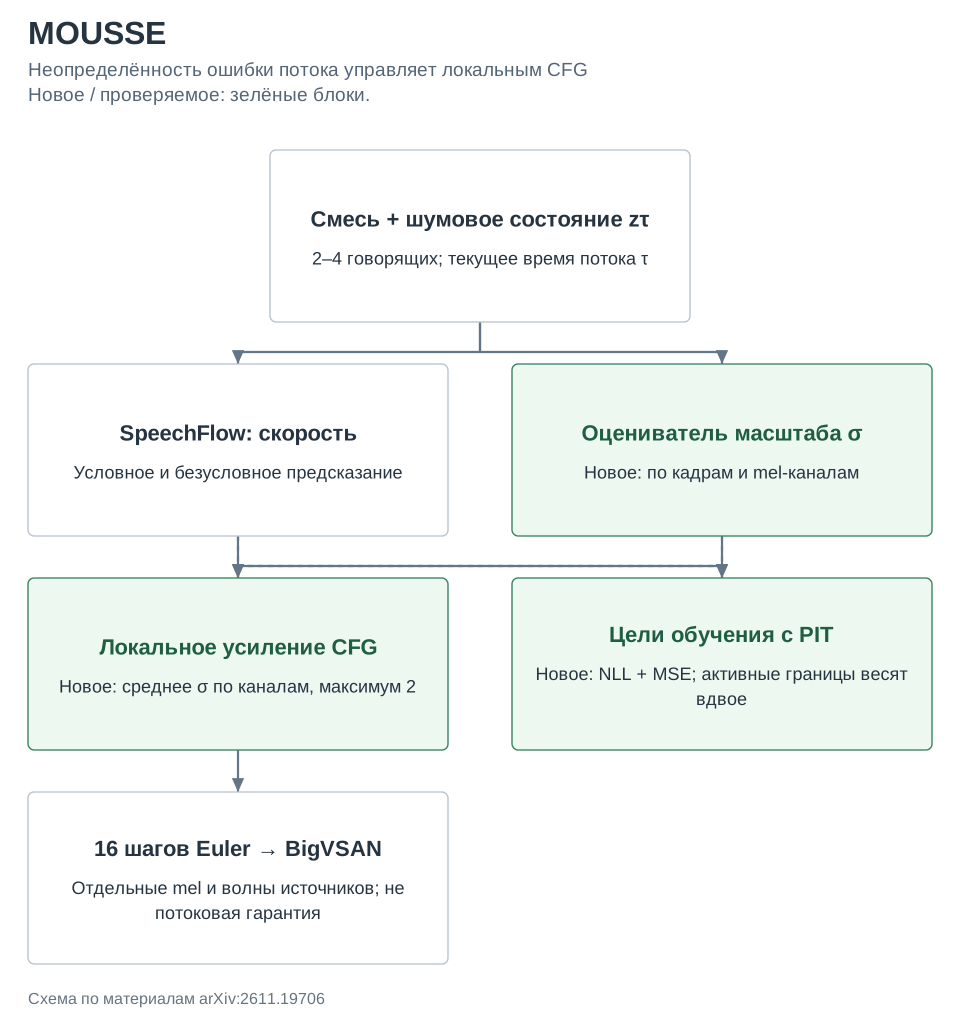
Результаты. На MuSSeD MOUSSE получает SI-SDRi 13,18 дБ и ESTOIi 0,175 против 11,60 дБ и 0,092 у сильнейшего сравниваемого SR-CorrNet. SI-SDRi измеряет улучшение разделения относительно смеси, ESTOIi — изменение объективной разборчивости, а не долю верно распознанных слов. Базовые модели переобучены на том же наборе. Английские смеси заметно легче корейских: 14,79 против 10,81 дБ SI-SDRi. Предсказанный масштаб связан с ошибкой скорости потока, корреляция Spearman 0,884 по активным кадрам, но это ещё не калиброванная вероятность ошибки распознавания.
Ограничения. Два языка и искусственное смешивание чистых записей не представляют шумные реальные разговоры. Сравнение включает нейровокодер BigVSAN для генеративных моделей, в отличие от прямых волновых выходов других систем. Не показаны субъективная оценка, RTF, память или потоковая задержка. Неопределённость описывает остаток предсказания потока, а не универсальную уверенность в личности, словах или количестве участников. Указанные параметры CFG относятся к конкретной шкале обученного оценивателя.
Фишка из статьи. Таблица 2 позволяет не преувеличивать роль «адаптивности». Фиксированный CFG у уже полностью обученной модели отстаёт всего на 0,20 дБ, тогда как удаление граничных весов или NLL даёт более крупные потери. В варианте без NLL одновременно исчезает основа адаптивного CFG, поэтому этот опыт оценивает связку компонентов.
| Вариант | SI-SDRi, дБ ↑ | ESTOIi ↑ |
|---|---|---|
| Полная модель | 13,18 | 0,175 |
| Та же модель, фиксированный CFG 0,166 | 12,98 | 0,172 |
| Без граничных весов | 12,10 | 0,164 |
| Без NLL, фиксированный CFG | 11,93 | 0,142 |
| Только PIT MSE по активным кадрам | 10,52 | 0,138 |
Как это читать: основной вклад связан с тем, чему и где учится модель. Локальная подстройка генерации полезна, но не объясняет весь выигрыш, а отсутствие одного компонента нельзя всегда трактовать как изолированный причинный эффект.
Источник. Оригинальное название: MOUSSE: Multilingual Overlapped Speech Separation with Predictive Uncertainty Estimation. arXiv:2611.19706; полный текст PDF.