Pixel-KWS: устойчивость поиска ключевых слов через изображения символов
Если пользователь записал ключевую фразу с похожими буквами другого алфавита или заменил букву цифрой, обычное текстовое представление может сильно измениться при почти неизменном внешнем виде строки. Pixel-KWS кодирует не номера символов, а их маленькие изображения и сопоставляет полученный вектор со звуком. Речь при проверке не искажается: исследуется устойчивость текстового задания поиска, а не подавление акустического шума.
Метод. Каждый символ отображается в изображение 16×16 пикселей шрифтом bold DejaVu Sans Mono. Трёхслойная свёрточная сеть даёт 64-мерное представление символа, двухслойная двунаправленная GRU и объединение с вниманием — вектор всей фразы. Пробел отличается от заполнения благодаря маске. Звуковая ветвь использует log-mel, свёрточное сокращение времени, четыре блока Conformer и тот же размер итогового вектора. Обучение сочетает двунаправленную InfoNCE, вспомогательную CTC и бинарную цель для калиброванного косинусного сходства. Изображения символов и векторы заданных слов можно кешировать; один запрос сравнивается скалярным произведением с каждым ключевым словом. Это не означает постоянную стоимость для произвольного количества слов.
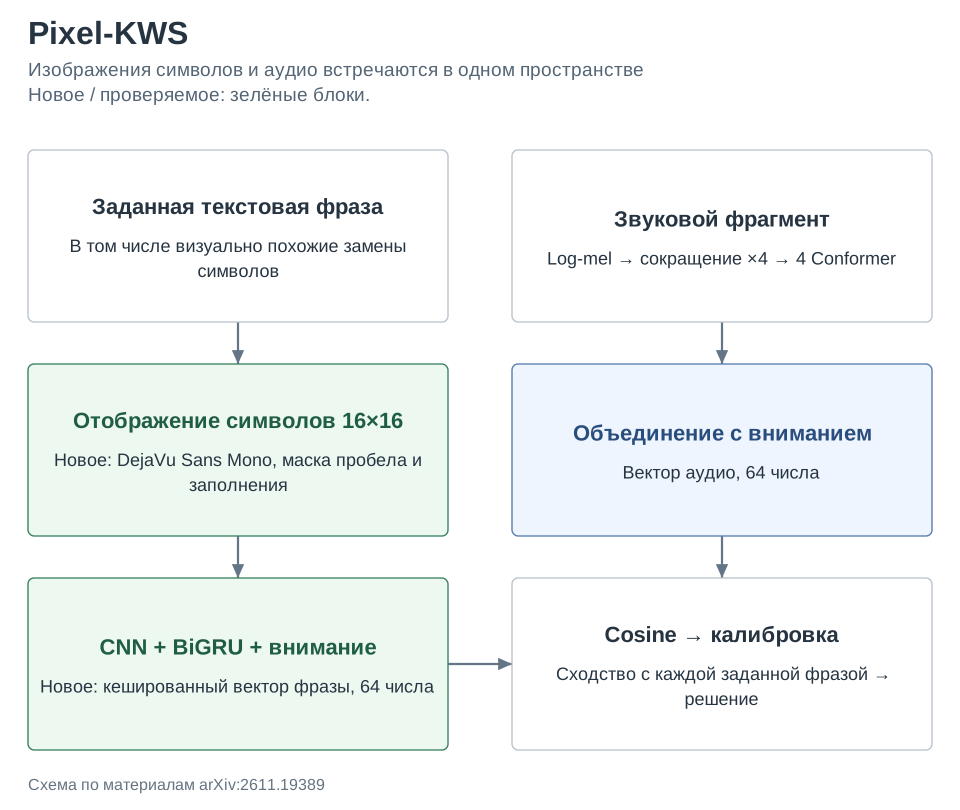
Результаты. На чистом LibriPhrase средняя конфигурация Pixel-M с 11,4 млн параметров получает EER 9,57% на сложной LPH и 0,41% на простой LPE; посимвольная Char-M — 9,55% и 0,43% по таблице 1 полного текста. То есть на чистом вводе нет существенного общего выигрыша. При максимальной вероятности замены визуально похожих символов прирост EER у Char-M составляет около 31,3 и 25,2 процентного пункта, у Pixel-M — 11,2 и 2,2. Для замен типа l33t преимущество меньше: на LPH ухудшение 22,07 пункта против 26,46. Вероятность замены 1 не означает изменение всех букв: словарь замен покрывает лишь часть символов.
Ограничения. Проверка ограничена английским LibriPhrase, одним шрифтом и заранее заданными преобразованиями строк. Перенос на другие письменности, произвольные шрифты и непрерывный поток речи не доказан. Нет измерения RTF, задержки срабатывания или батарейного устройства. Изображения помогают сходным написаниям, но не обязаны разрешать случаи, когда одинаково выглядящие символы имеют разное произношение.
Фишка из статьи. Таблица 3 даёт полезный отрицательный результат: увеличение картинки символа почти не меняет чистую точность, хотя число параметров немного растёт. Это абляция маленькой конфигурации, не Pixel-M; её нельзя смешивать с основными средними результатами.
| Картинка, маленькая модель | Параметры, млн | EER LPH, % | EER LPE, % |
|---|---|---|---|
| 8×8 | 0,85 | 12,28 | 0,58 |
| 16×16 | 0,86 | 12,10 | 0,60 |
| 24×24 | 0,89 | 12,25 | 0,58 |
Как это читать: полезна сама визуальная близость символов, а не высокое разрешение. Размер 16×16 является разумным инженерным выбором, но не статистически установленным универсальным оптимумом.
Источник. Оригинальное название: Pixel-KWS: Rendered-Glyph Representations for Orthographically Robust Open-Vocabulary Keyword Spotting. arXiv:2611.19389; полный текст PDF.