PnP-MVDR: нейросетевой речевой приоритет внутри итерационного лучеформирования
Классический MVDR сохраняет сигнал с заданного направления, но сам по себе не знает, как должна выглядеть речь. PnP-MVDR добавляет это знание через готовый нейросетевой подавитель шума: он участвует в итерационном согласовании решения, а не просто очищает готовый выход. Работа интересна соединением пространственной модели и речевого приоритета, а также сравнением порядка обработки микрофонных каналов.
Метод. В частотно-временной области к задаче минимальной выходной мощности с единичным усилением целевого направления добавляют регуляризацию RED, зависящую от разности сигнала и его очищенной версии. Разделение переменных приводит к чередованию обновления весов лучеформирователя, нейросетевого шага и вспомогательных переменных. Во внутреннем шаге смешивают текущую оценку с выходом подавителя шума; число внутренних итераций установлено в единицу. Вставляются готовые DCCRNet, DCUNet или FRCRN без совместного переобучения. Используются 16 кГц, окно Hann 32 мс, шаг 16 мс и FFT 512. Создан восьмимикрофонный линейный массив с расстоянием 1,3 см; в моделировании геометрия другая, 3 см. Предлагаемое разделение нагрузки между DSP и NPU является архитектурой реализации, не измерением её задержки.
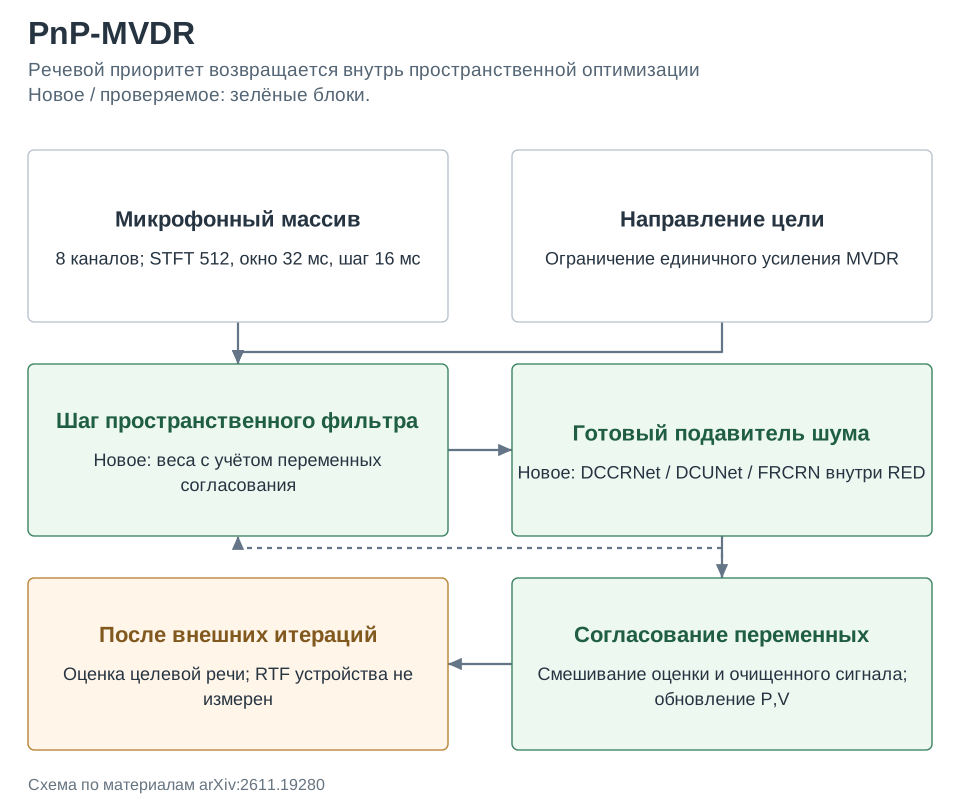
Результаты. На реальных записях с шумом кафе PnP-MVDR с FRCRN даёт PESQ 1,53 и STOI 0,80 против 1,23 и 0,67 у MVDR; простая последовательность MVDR → FRCRN достигает 1,47 и 0,78. Для заводского шума соответствующий PESQ равен 1,55 против 1,20 и 1,41. Преимущество не безусловно по всем метрикам: при белом шуме 0 дБ в моделировании последовательная очистка после MVDR даёт PESQ 1,89, а PnP с тем же FRCRN — 1,72, хотя частотно-взвешенное сегментное отношение сигнал/шум у PnP выше.
Ограничения. Реальная проверка мала: десять пар реплик WSJ0, три шумовых сценария, всего 30 смесей; моделирование содержит 90 смесей и комнату с T60=0. Настройки подбирались по одной записи каждого сценария. Для реальных сигналов перед оценкой выполняют временное согласование с эталоном. Обсуждение 4 GMAC/с и возможностей DSP/NPU не заменяет опубликованный RTF, потребление энергии или сквозную задержку готового устройства. Слуховой тест и проверка распознавания отсутствуют.
Фишка из статьи. В таблице III особенно показателен не только PnP, но и провал независимой очистки каналов до MVDR. Для кафе один и тот же FRCRN в трёх соединениях даёт очень разную разборчивость. Авторы связывают это с нарушением межканальных фазовых отношений; таблица поддерживает наблюдение о порядке операций, но не изолирует фазу отдельной причинной абляцией.
| Соединение с FRCRN, реальное кафе | PESQ | STOI |
|---|---|---|
| Очистка каждого канала → MVDR | 1,35 | 0,45 |
| MVDR → очистка | 1,47 | 0,78 |
| Итерационный PnP-MVDR | 1,53 | 0,80 |
Как это читать: монофонически хороший подавитель не обязательно сохраняет пространственные признаки массива. Небольшой выигрыш PnP над хорошим последовательным вариантом нужно сопоставлять с ценой нескольких нейросетевых вызовов; эта цена здесь не измерена.
Источник. Оригинальное название: Hardware-Friendly Plug-and-Play MVDR Beamforming for Microphone Arrays: Algorithm, Prototype, and System-Level Feasibility. arXiv:2611.19280; полный текст PDF.