Синтез речи со слуховой обратной связью: неявная адаптация Ломбарда к шуму
Синтезатор обычно не слышит, насколько понятен его собственный голос на фоне шума. Здесь CosyVoice2 получает две обратные связи от зашумлённого результата: оценку наличия шума и признаки затруднения распознавания. Они меняют условие flow matching без явной команды поднять F0 или громкость; работа проверяет, приводит ли это к полезной, а не просто заметной реакции на шум.
Метод. Замороженная SNRNet выдаёт вероятности чистого звука, 0 и −10 дБ; сумма двух шумовых вероятностей становится непрерывным условием. Замороженный Whisper вычисляет последовательность ошибок предсказания известных текстовых токенов, которую свёрточный модуль сжимает в 512-мерный вектор. Обе ветви проецируются в 80-мерное условие акустического Flow; языковая модель и HiFT не дообучаются. В статике сначала синтезируется вся реплика, затем выполняется уточнение по её зашумлённой версии. В динамике используются только предыдущие допустимые наблюдения: блоки по 25 токенов, скользящее окно трёх блоков, проверка устойчивого выравнивания слов. Если обратная связь ненадёжна, сохраняется прежнее значение. Это условный признак, не обратное распространение градиента через распознаватель.
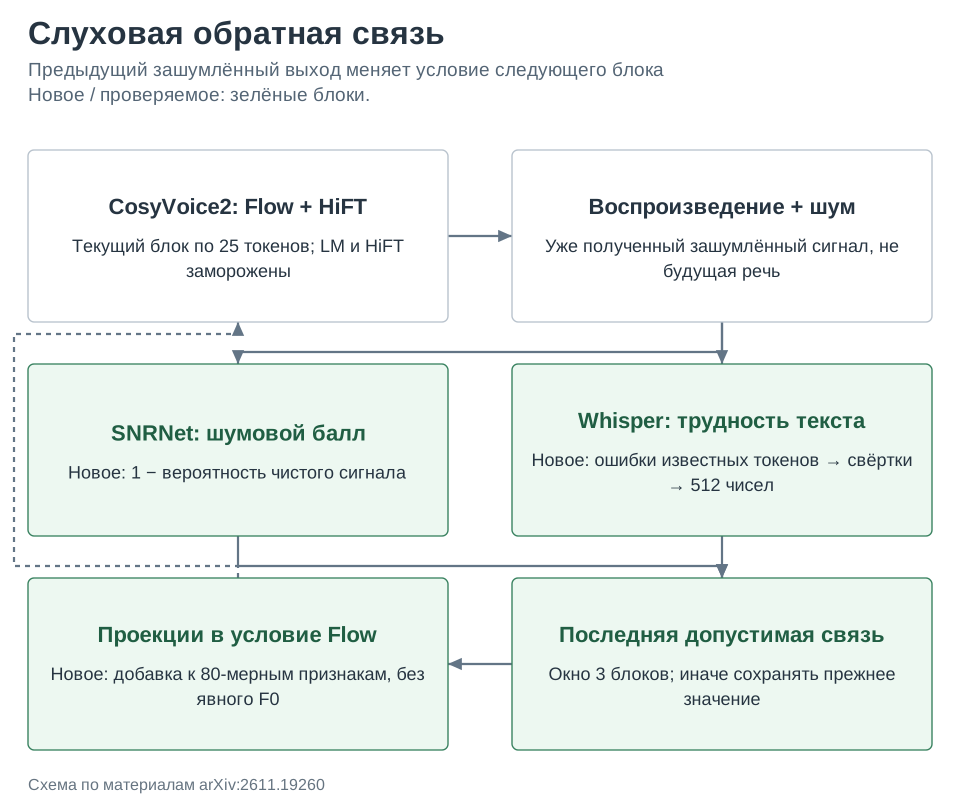
Результаты. Обучение использует парную обычную и ломбардную речь 54 дикторов Grid с непересекающимися группами 45/2/7. На незнакомом динамическом WHAM-шуме +5→−5→−15 дБ при обычной подсказке совместная связь снижает WER с 55,5% после обычного дообучения до 49,3%. Только распознавательная связь получает лучшую STOI 0,586 против 0,572 у дообучения, но WER 55,4%, почти без выигрыша. Внутри обученного шумового домена преимущества менее последовательны; обычное парное дообучение уже является сильным сравнением. В слуховой части участвуют 63 человека, но чистые варианты оценивают естественность и уместность адаптации, а не напрямую распознавание слов в шуме.
Ограничения. Каждому результату шум подмасштабируют для заданного отношения сигнал/шум, поэтому это не доказательство выгоды увеличения громкости при фиксированном реальном шумовом поле. Для временных границ используются чистые сигналы; это ограничивает автономность протокола. Обновление распознавательной связи на A800 при batch=1 занимает медиану 214,3 мс и p95 298,9 мс, не считая всего тракта синтеза; причинность не означает нулевую задержку. Совместная модель дополнительно обучается 30 эпох после SNR-варианта, что усложняет строгое сравнение одинакового бюджета.
Фишка из статьи. Таблица 3B отделяет полезную обратную связь от внешне убедительного следования шуму. Распознавательная ветвь сильнее связывает громкость с тяжестью предыдущего шума, однако совместная модель существенно лучше по WER. Коэффициент корреляции не является самостоятельной целью качества.
| Связь, незнакомый WHAM | WER, % ↓ | STOI ↑ | Корреляция мощности с шумом ↑ |
|---|---|---|---|
| Без связи, парное дообучение | 55,5 | 0,572 | 0,113 |
| Только распознавательная | 55,4 | 0,586 | 0,508 |
| Совместная SNR+ASR | 49,3 | 0,566 | 0,085 |
| Только SNR | 57,4 | 0,569 | −0,006 |
Как это читать: лучшее следование громкости не совпадает с лучшим распознаванием, и лучшие WER и STOI также принадлежат разным вариантам. Нужен набор критериев, а не один показатель «похожести на эффект Ломбарда».
Источник. Оригинальное название: Auditory-Feedback-Conditioned Flow TTS for Implicit Lombard Adaptation. arXiv:2611.19260; полный текст PDF.