ProSing: локальное управление вокальными приёмами для незнакомых певцов
ProSing меняет отдельные участки существующей вокальной записи: добавляет дыхательное звучание, фальцет, вибрато или глиссандо, стараясь сохранить слова, мелодию, время и певца. Главное изменение касается обучения: модель не должна подсматривать требуемый приём в акустическом условии вместо выполнения явной команды. Для высотных приёмов бинарной метки оказывается недостаточно, поэтому задаётся непрерывная траектория.
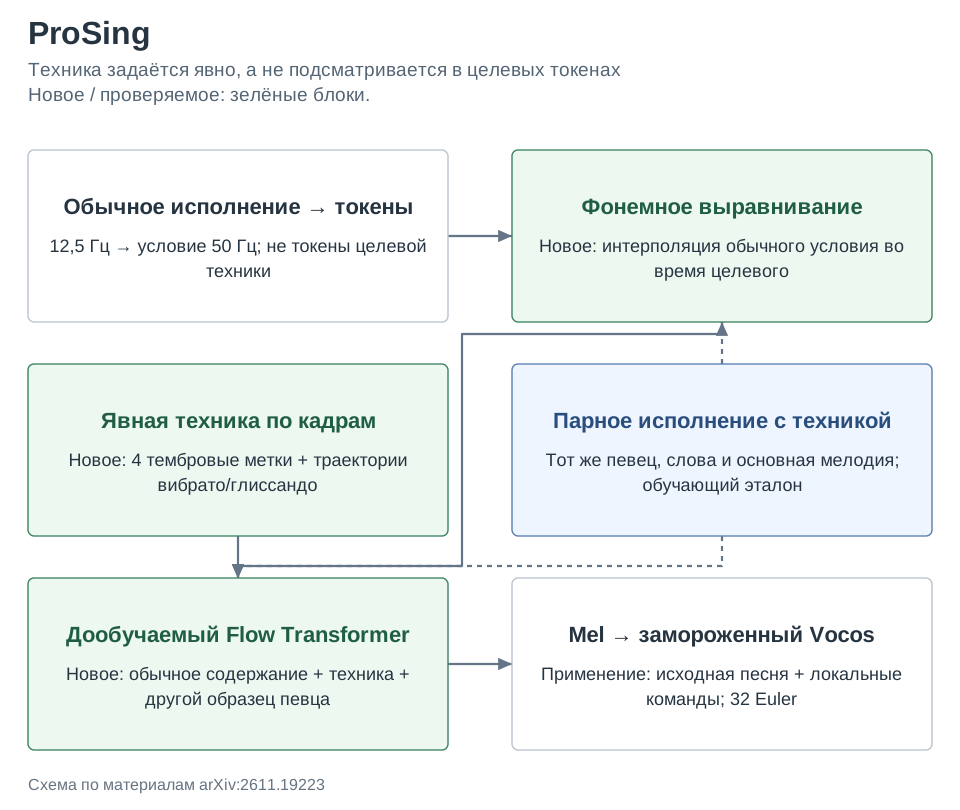
Метод. Основа Vevo1.5 сохраняет замороженные признаки Whisper и chromagram, токенизатор 12,5 Гц и Vocos; токены разворачиваются в условие 50 Гц для дообучаемого flow matching. В паре обычного и специального исполнения обе ветви получают содержание обычной записи. Для специальной ветви оно интерполируется во времени по фонемным границам и выравниванию Левенштейна. Голосовая подсказка берётся из другой обычной записи того же певца, что уменьшает утечку приёма. Четыре тембровые техники задаются покадровыми метками; вибрато — траекторией pYIN после удаления медленного движения и фильтрации 3–9 Гц, глиссандо — разностью согласованных траекторий. На применении условие берётся из исходной записи, а изменяемая техника — из явного управления; используется 32 шага Euler.
Результаты. Адаптация использует GTSinger, 80,59 ч / 20 певцов / 9 языков, и дополнительные 53,06 ч для сохранения обобщения. На незнакомых певцах субъективная естественность равна 3,36±0,22 против 2,41±0,28 у Vevo1.5, сходство певца 3,13±0,22 против 2,68±0,25. В китайском поднаборе CER 27,6% против 39,5%; сама исходная запись имеет CER 23,5%, поэтому преобразование всё же теряет часть содержания. Для 24 тембровых примеров ошибка F0 равна 166,7 цента против 332,8. Эти показатели не доказывают неизменность мелодии в каждом случае.
Ограничения. Слуховой тест включает 28 участников, объективные срезы малы. Сравниваемый TCSinger получает автоматически извлечённую партитуру и работает в иной постановке, поэтому его сильное отставание нельзя приписать только предложенному обучению. Оценщик STARS сам плохо распознаёт некоторые высотные приёмы: F1 0,380 для вибрато и 0,534 для глиссандо на реальных данных. Парные записи и фонемные границы дороги; причинный поток, RTF и задержка не проверены. Преобразование одного уже выраженного приёма в другой оставлено на будущее.
Фишка из статьи. Последние строки таблицы 2 показывают реальный компромисс: дополнительные певческие данные возвращают сходство личности, но ослабляют выполнение техники. Следовательно, более высокое качество сохранения голоса не равно лучшей управляемости. Это последовательные конфигурации абляции, не независимые одинаковые по бюджету запуски.
| Вариант | F1 одной техники | F1 нескольких техник | SpkSim |
|---|---|---|---|
| Только метки, начальная адаптация | 0,143 | 0,117 | 0,753 |
| Парное обучение + выравнивание | 0,389 | 0,228 | 0,533 |
| Траектории + более долгое обучение | 0,439 | 0,291 | 0,521 |
| Плюс дополнительные певческие данные | 0,374 | 0,216 | 0,631 |
Как это читать: высокий SpkSim начального варианта отчасти сопровождает слабое изменение исходного исполнения. Для рабочего редактора полезнее раздельно контролировать точность команды, сохранение личности и искажение слов/высоты, чем свести их к одному баллу.
Источник. Оригинальное название: ProSing: Zero-Shot Fine-Grained Singing Technique Conversion. arXiv:2611.19223; полный текст PDF.