За пределами управляемости: насколько разнообразны голоса синтеза по текстовой инструкции
Умение синтезировать «женский голос» ещё не означает умения выдать много разных женских голосов. Работа проверяет семь открытых синтезаторов в режиме только текстового описания, без голосового образца, и разделяет выполнение инструкции и разнообразие личностей. Особенно полезна предварительная проверка измерительного инструмента: хороший дикторский кодировщик для верификации не автоматически подходит для оценки разнообразия.
Метод. Авторы начинают с 11 кодировщиков и контролируемых подмножеств LibriSpeech: всегда 240 реплик, но от 6 до 240 разных дикторов, по 100 выборок на каждое количество. Отбираются восемь кодировщиков, чьи показатели уверенно различают соседние значения; x-vector, WavLM-base+SV и UniSpeech-SAT-base+SV в этой постановке исключаются. Основная мера Vendi — экспонента энтропии собственных значений нормированной матрицы косинусного сходства; это эффективное число направлений, не буквальное количество людей. Дополнительно измеряется среднее попарное косинусное расстояние. Для общего сравнения синтезируют 30000 текстов Emilia и сравнивают с реальными записями тех же текстов в трёх группах по 10000. Для отдельных атрибутов используются одинаковые 3000 текстов и фиксированные подвыборки по 1500.
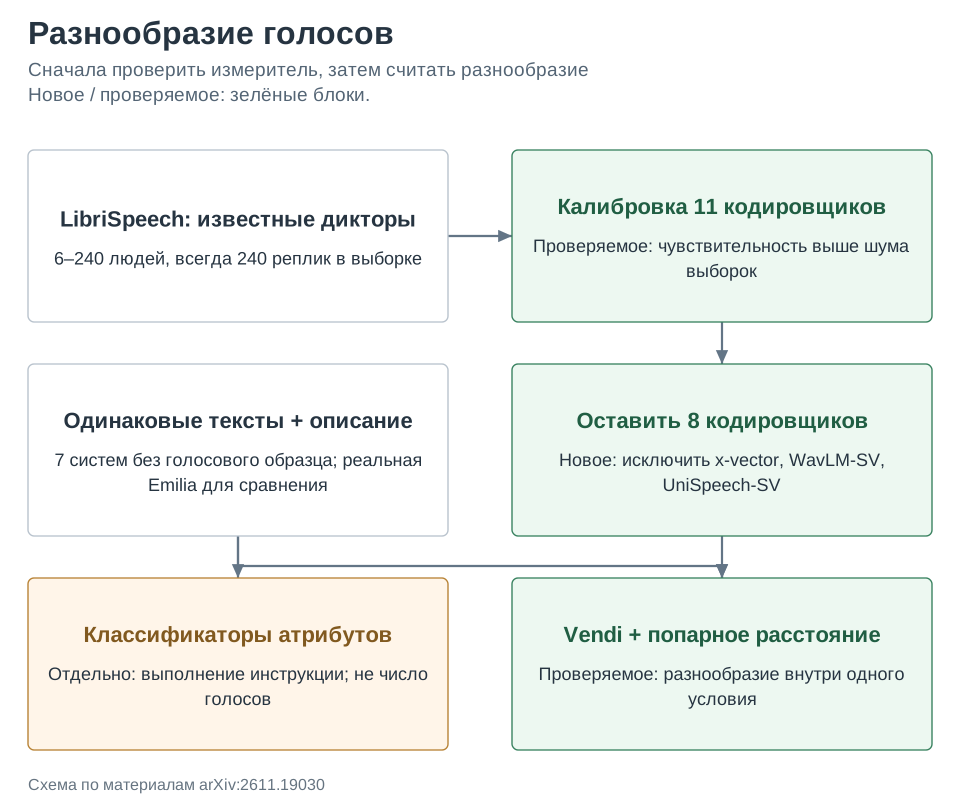
Результаты. Все семь систем уступают реальной речи по обеим мерам и каждому из восьми принятых кодировщиков. В шести системах полнота выполнения мужских и женских инструкций выше 0,88 для обоих классов, но в пяти женские голоса менее разнообразны. У Qwen3-TTS Vendi равен 16,6 для женской и 28,1 для мужской инструкции, около 59%. Изменение температуры или CFG у трёх систем не закрывает разрыв с реальными записями. Североамериканский английский воспроизводится надёжнее других акцентов: полнота не ниже 0,744 у всех моделей, тогда как разные региональные группы часто не превосходят случайный уровень.
Ограничения. Все основные тексты английские; калибровка пространства выполнена на LibriSpeech и может не охватывать синтетические артефакты. Реальная Emilia содержит более широкий диапазон записывающих условий, которые также способны влиять на векторы. Атрибуты оцениваются классификаторами со своими ошибками; отсутствие разнообразия нельзя полностью отделить от предвзятости измерителя. Показатели подвыборок не заменяют проверку независимого повторного синтеза всей коллекции. Это аудит выбранных версий и режимов, не утверждение о любой модели семейства или клонировании по образцу.
Фишка из статьи. Таблица 1 раскрывает взаимодействие возраста и пола, которое теряется в одном среднем. У Qwen3-TTS детская женская инструкция особенно сжимает пространство голосов, а у пожилых направление различия меняется. Числа ниже относятся к совместным условиям и другой организации выборки, поэтому их нельзя напрямую вычитать из отдельных гендерных оценок 16,6 и 28,1.
| Совместная инструкция, Qwen3-TTS | Женские голоса: Vendi | Мужские голоса: Vendi |
|---|---|---|
| Дети | 6,5 | 25,2 |
| Молодые взрослые | 9,5 | 19,9 |
| Средний возраст | 24,6 | 27,3 |
| Пожилые | 27,7 | 25,6 |
Как это читать: низкий Vendi указывает на концентрацию представлений, а не на обнаружение ровно шести или двадцати голосов. Для синтетического обучающего корпуса нужно одновременно проверять выполнение описания, разнообразие внутри него и качество звука.
Источник. Оригинальное название: Beyond Controllability: Speaker Diversity in Instruction-Guided Text-to-Speech. arXiv:2611.19030; полный текст PDF.