Facto: факторизованные речевые токены с отдельным представлением диктора
Facto отделяет меняющееся содержание и просодию от более постоянных свойств диктора и записи до квантования речевых признаков. Ключевое расширение линейной факторизации — общий оцениватель содержания, которому не нужна заранее известная матрица нового диктора. Интересен результат для генерации: токенизатор с не лучшим восстановлением исходной записи оказывается удобнее для языковой модели синтеза.
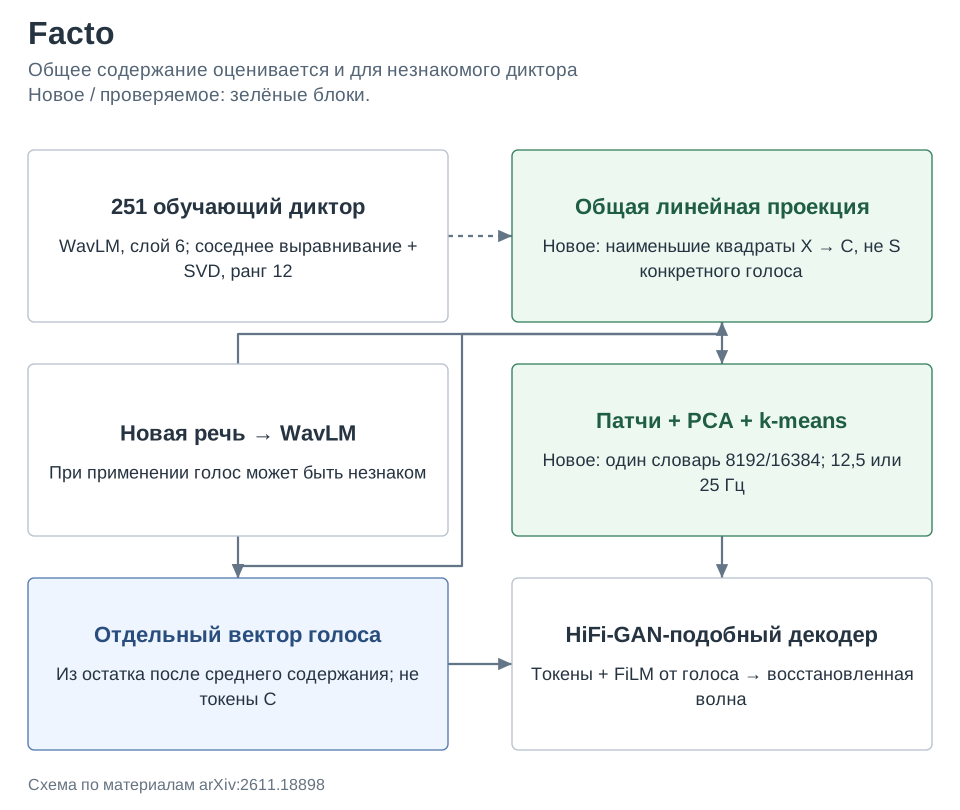
Метод. Признаки шестого слоя WavLM выравниваются ближайшими соседями между 251 диктором LibriSpeech train-clean-100. Совместное низкоранговое разложение Xk≈CSk через SVD выделяет общее 12-мерное пространство C и преобразования дикторов. Метод наименьших квадратов учится напрямую получать C из признаков незнакомого голоса. Соседние кадры объединяются в пары или четвёрки, PCA сохраняет 95% дисперсии, k-means формирует один словарь на 8192 или 16384 элемента с темпом 25 либо 12,5 токена/с. HiFi-GAN-подобный декодировщик получает токены и отдельный глобальный вектор голоса; FiLM возвращает свойства диктора. Вектор извлекается из остатка признаков после удаления среднего содержания. Кодировщик факторизации обучается менее часа на CPU, но это не время предобучения WavLM и декодировщика.
Результаты. На восстановлении LibriSpeech test-clean при 12,5 Гц и словаре 16384 Facto получает WER 5,0%, SIM 0,93 и предсказанный MOS 4,37; Kanade — 3,5%, 0,93 и 4,35. Зато при одинаковой малой языковой модели синтеза на Seed-TTS test-en Facto достигает WER 2,3% против 4,5% у Kanade, со сходством 0,94 против 0,92. На Expresso ошибки остаются высокими, но 9,8% лучше 18,9%. Устойчивость токенов к малым шумовым возмущениям по UED примерно вдвое выше сопоставляемых решений. Слуховой MUSHRA показывает особенно большой выигрыш сходства с образцом, а не безусловный рост естественности.
Ограничения. Опыты завязаны на один слой WavLM и главным образом английские корпуса. Глобальный вектор может сглаживать изменения голоса внутри реплики. Это представление для генерации и восстановления, не законченная потоковая спецификация сжатия: вектор диктора также нужно передавать, что особенно дорого для короткого файла. Только индексы словаря требуют 162,5–175 бит/с при 12,5 Гц или 325–350 при 25 Гц без энтропийного кодирования; это наш расчёт темп×log2(словарь), не полный битрейт. Задержка, память и RTF готового кодека не установлены.
Фишка из статьи. Таблицы 1 и 2 меняют порядок моделей при переходе от восстановления к синтезу. Внутри Facto удвоение словаря при 25 Гц слегка улучшает восстановление, но ухудшает WER синтеза. Значит, максимальная акустическая точность не является достаточным критерием выбора токенов для генеративной модели.
| Модель / словарь / темп | WER восстановления, % | WER синтеза, % |
|---|---|---|
| Kanade / 12800 / 12,5 Гц | 3,5 | 4,5 |
| Facto / 16384 / 12,5 Гц | 5,0 | 2,3 |
| Facto / 8192 / 25 Гц | 3,1 | 2,0 |
| Facto / 16384 / 25 Гц | 3,0 | 2,8 |
Как это читать: две колонки относятся к разным тестам: LibriSpeech test-clean и Seed-TTS test-en. Сравнивать нужно порядок моделей внутри каждой колонки. Устойчивость, распределение токенов и сложность их предсказания могут быть важнее небольшой прибавки точности реконструкции.
Источник. Оригинальное название: Factorized Self-Supervised Speech Tokenization. arXiv:2611.18898; полный текст PDF.