Лёгкое обнаружение воспроизведённой речи по пространственным и фазовым признакам
Отличать живого говорящего от записи на динамике предлагается по физическим изменениям звукового поля, а не по большой нейросети. Система объединяет межмикрофонные задержки, фазовые колебания и низкочастотные признаки воздушных толчков. Это экономный обнаружитель повторного воспроизведения, но его точность заметно зависит от решётки и комнаты; физическая интерпретация признаков не доказывает их неуязвимость.
Метод. Из первого секундного многоканального фрагмента ReMASC извлекаются задержки GCC-PHAT в окнах 32 мс с шагом 16 мс и ограничением лага ±1 мс. По ним считают аналоги скорости и ускорения, а также среднее положение и дрожание. STFT даёт межканальные различия уровней и синус разности фаз; статистики по времени и частоте дополняются частотой смены знака фазовой скорости. Фильтр Butterworth четвёртого порядка ниже 150 Гц оценивает долю низкочастотных импульсов; добавляются изменения спектрального центра. XGBoost получает 158 признаков для шестимикрофонного D3 и 215 для семимикрофонного D4. Это фиксированные признаки, а не обучаемое разделение источников или фазовое улучшение речи.
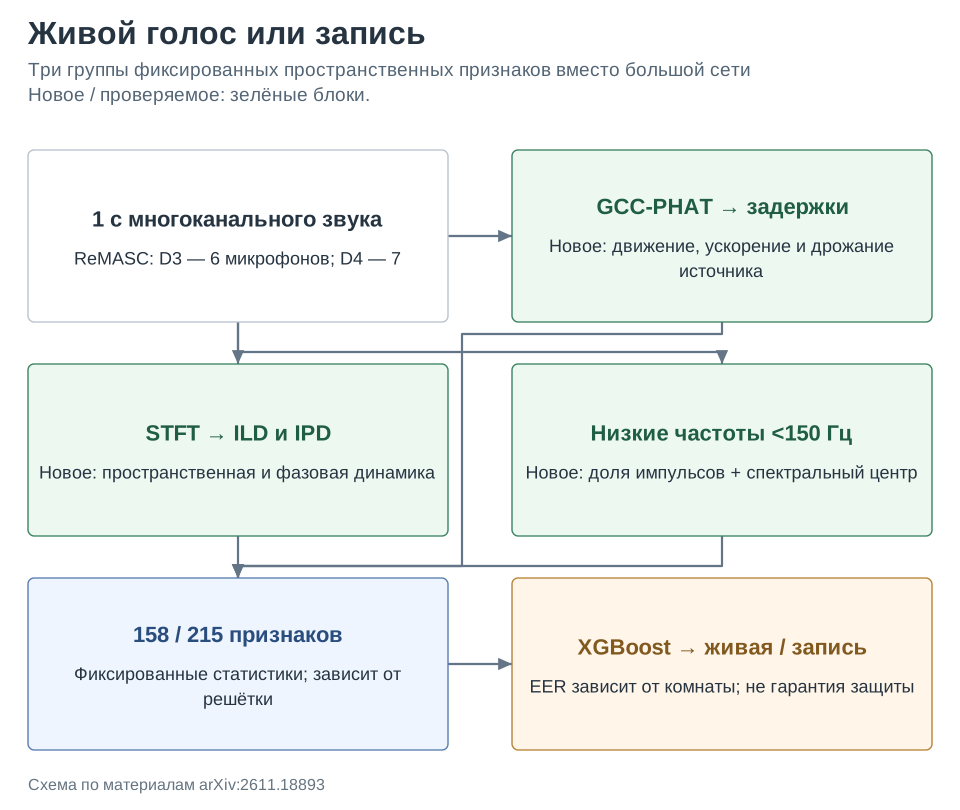
Результаты. В стандартном протоколе EER равен 17,8±0,3% на D3 и 24,0±0,1% на D4. Более тяжёлый M-ALRAD точнее: 10,4±2,1% и 14,2±0,8%. Для Cortex-M7 авторы оценивают модель в 0,6 МБ и вычисление секундного фрагмента в 0,90 с на D3 либо 0,26 с на D4 с INT16 и SIMD. Это ресурсная оценка, не воспроизводимый замер полноценного устройства в статье; 0,6 МБ также нельзя автоматически считать всей пиковой памятью аудиобуферов и преобразований. К времени вычисления добавляется накопление секунды звука.
Ограничения. Число микрофонов смешано с геометрией и частотой дискретизации: D3 записывает 44,1 кГц, D4 — 16 кГц. Нельзя приписать различия одному лишь количеству каналов. Важность признака XGBoost не доказывает причинную «живость»: неподвижный человек, движущийся динамик или запись с сохранённой пространственной динамикой требуют отдельной проверки. В незнакомой среде ошибки велики, особенно в автомобиле и большом помещении. Не проверена универсальная защита от всех синтетических и повторно воспроизводимых атак.
Фишка из статьи. Таблица III показывает, как меняется вывод при исключении целой среды из обучения. Ниже приведён EER для модели, усреднённый по всем устройствам D1–D4, и отдельно по многоканальным D3–D4; это не парная абляция добавления одного микрофона.
| Незнакомая среда | D1–D4, EER % ↓ | D3–D4, EER % ↓ |
|---|---|---|
| A: улица | 37,0 | 26,0 |
| B: помещение | 40,7 | 39,3 |
| C: помещение | 30,5 | 20,5 |
| D: автомобиль | 48,8 | 42,2 |
Как это читать: плотная решётка помогает не везде: в среде B разница мала, а в автомобиле ошибка остаётся близка к случайному разделению. В среде C 20,5% лучше традиционного CQCC-GMM с 34,6%, но M-ALRAD имеет 15,1%. Практический компромисс — ограниченный бюджет против точности и переноса, не доказанное общее превосходство физически объяснимых признаков.
Источник. Оригинальное название: Lightweight Replay Attack Detection via Interpretable Physical Descriptors. arXiv:2611.18893; полный текст PDF.