Победа в рейтинге и потеря устойчивости: сужение домена малоресурсного распознавания речи
Дообученная модель может занять первое место на привычных тестах языка и уступить исходным весам при смене условий записи. Автор разбирает собственный такой результат для турецкого распознавания и проверяет его независимо построенными тестами, затем повторяет опыт на казахском. Главная практическая мысль: новый проверочный набор из прежнего источника данных способен скрыть именно тот ущерб, который должен обнаруживать.
Метод. Первый LoRA-вариант whisper-large-v3-turbo обучен на 997,2 ч преимущественно подкастов, медиа, лекций и Common Voice. Внешняя команда построила сетку из 100 одинаковых реплик FLEURS-TR в 20 условиях: чистый звук, MUSAN при 20/10/0 дБ, Opus 32/16/12/8 кбит/с и сочетания шума со сжатием. Это отделяет эффект среды от текста внутри сетки. Восстановительная попытка меняет смесь, переходит на large-v3, выбирает по отношению к исходной модели и усредняет контрольные точки одной траектории. Отдельно проверяются узкое дообучение на казахском и сравнение Whisper с CTC-моделью MMS при близкой доле обучаемых параметров.
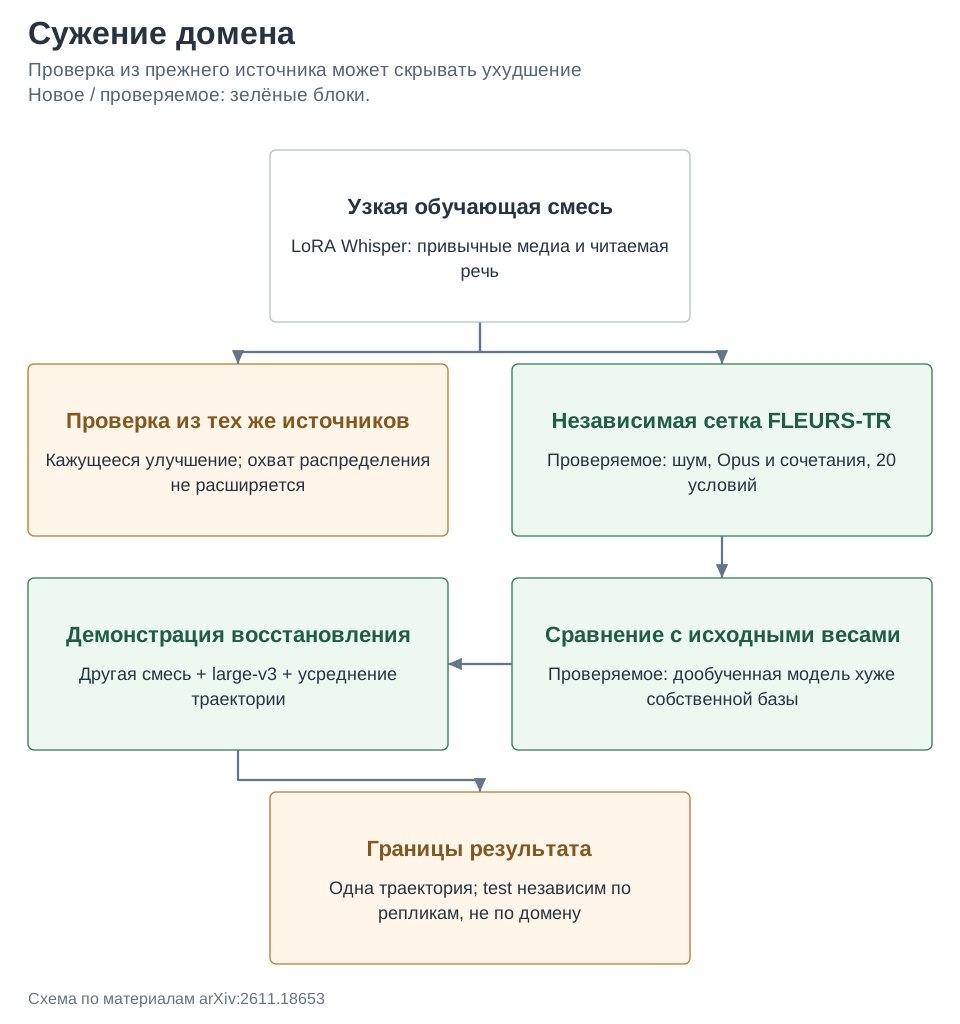
Результаты. На MediaSpeech рейтинговый вариант даёт WER 9,02% против 11,93% у исходного large-v3. Но на независимой сетке его собственная база turbo лучше: чистая речь 6,55% против 9,18%, среднее по 20 условиям 10,92% против 13,49%. После восстановительной процедуры на полном FLEURS-TR test получены 8,16% против 8,26% у large-v3; парный интервал различия включает ноль, поэтому это паритет, не доказанная победа. На казахском узкое дообучение улучшает FLEURS с 33,19% до 31,90%, но ухудшает внешний KSC2 с 57,39% до 58,64%. Проверка другой программной реализации и фиксированного декодирования поддерживает основной диагноз.
Ограничения. «Акустическое сужение» здесь относится к совокупности доменных различий: акустике, стилю, тематике и говорящим, а не к изолированному физическому параметру. Исходная турецкая сетка содержит только 100 текстов. Восстановление выполнено по одной траектории, и FLEURS-dev участвует в остановке: test исключён по репликам, но его распределение не независимо от выбора модели. Приватный рейтинговый тест служит сигналом проблемы, не воспроизводимым доказательством. Сравнение Whisper и MMS не изолирует причинную роль декодировщика, поскольку модели различаются также предобучением и токенизацией.
Фишка из статьи. Таблица 6 ограничивает сильную формулировку «дообучение всегда портит перенос». Обе модели адаптируют на одном краудсорсинговом домене KSC2, а проверяют на пяти других доменах того же корпуса. Изменения WER имеют противоположный знак; повторение с тремя начальными случайными состояниями сохраняет этот знак.
| Система | Обучаемая доля | Δ WER вне домена, п.п. | Среднее ± SD, 3 запуска |
|---|---|---|---|
| Whisper, attention encoder–decoder | 2,00% | +2,23 [+1,19; +3,26] | +2,28 ± 0,08 |
| MMS, CTC encoder-only | 1,60% | −3,46 [−3,81; −3,12] | −3,60 ± 0,19 |
Как это читать: положительная дельта означает ухудшение. Интервалы в третьей колонке получены повторным выбором тестовых реплик, SD в четвёртой описывает вариативность обучения: это разные источники неопределённости. Нужны проверки именно своей модели на независимо возникшем распределении, а не общий запрет адаптации.
Источник. Оригинальное название: Winning the Leaderboard, Losing the Distribution: Diagnosing and Mitigating Acoustic Narrowing in Low-Resource ASR. arXiv:2611.18653; полный текст PDF.