eDIAR: потоковая диаризация без переобучения и фиксированного общего числа участников
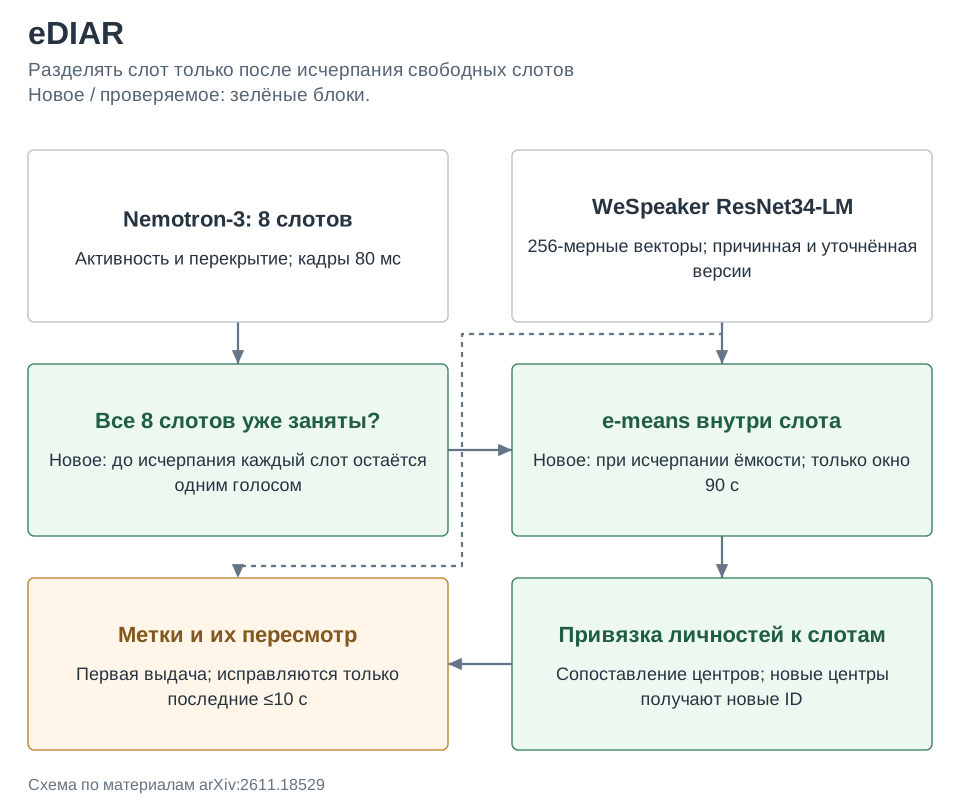
Нейросетевая диаризация с восемью выходными слотами не умеет непосредственно назвать девятого участника. eDIAR оставляет нейросети определение активности и перекрытий, а кластеризацию включает только для разделения уже занятого слота после исчерпания свободных. Это небольшое дополнение без переобучения, но с принципиально разными режимами первой выдачи и последующего исправления меток.
Метод. Основная система соединяет Nemotron-3 с восемью слотами и 256-мерные векторы WeSpeaker ResNet34-LM. До заполнения слотов каждый слот соответствует одному участнику; затем внутри слота выбирают несколько подкластеров по косинусному разделению и минимальной длительности. В потоковом варианте повторная кластеризация ограничена окном 90 секунд, личности привязаны к слотам и сопоставляются по центрам; можно пересматривать последние десять секунд. Позднее становятся доступны уточнённые центрированные по времени векторы. Отдельный архивный режим связывает личности между записями кластеризацией кадров; число архивных кластеров там задаётся отдельно.
Результаты. При буфере 1,04 с DER VoxConverse уменьшается с 6,4% у головы до 5,9% при первой выдаче и 5,8% после пересмотра. На синтетических LibriSpeech-OpenSpk это 19,8%, 18,5% и 16,4%; на ICSI практически нет выигрыша: 27,4%, 27,5% и 27,4%. DER измеряется с collar 0,25 с и учётом перекрытий. Средний RTF по 93 сессиям равен 0,10 на испытанном сервере с RTX 3090; он не включает ожидание пересмотра. На полных ICSI-встречах итоговая DER 28,6% немного хуже 28,5% исходной головы.
Ограничения. Отсутствие фиксированного общего числа участников не означает неограниченной мгновенной ёмкости: окно и число подкластеров конечны, быстрые чередования многих голосов остаются трудными. Большие собрания во многом синтетические; пороги подбирали на части сессий. Существенная доля выигрыша LibriSpeech появляется только после исправления меток. Для архивного сопоставления нужно задать или оценить число людей. Ускорение e-means на миллионе векторов не переносится автоматически на небольшую потоковую задачу.
Фишка из статьи. Таблица 24 даёт редкий отрицательный результат: внутри малой потоковой задачи e-means не быстрее Lloyd, хотя именно масштабируемость e-means полезна в архиве. Ниже вся потоковая система после пересмотра; все варианты используют ту же схему слотов, а меняется только движок кластеризации.
| Движок | DER Vox, % | DER Libri, % | Весь шаг, мс |
|---|---|---|---|
| e-means, по умолчанию | 5,8 | 16,4 | 49 |
| Lloyd, 25 итераций | 5,8 | 16,3 | 38 |
| Lloyd, 5 итераций | 5,8 | 16,1 | 36 |
| Mini-batch k-means | 5,8 | 16,6 | 37 |
Как это читать: в маленьком окне накладные расходы важнее числа проходов. Это не опровержение архивного ускорения: при 1,16 млн кадров и 1 251 личности в таблице 6 e-means за два прохода занимает 5,89 с против 43,86 с у Lloyd за 25. Важно выбирать движок под размер задачи и не приписывать весь выигрыш диаризации одному алгоритму кластеризации.
Источник. Оригинальное название: eDIAR: Training-Free Open-Speaker Streaming Diarization for Long Meetings and Large Archives via e-means. arXiv:2611.18529; полный текст PDF.