Marimba: вероятностные речевые решения на замороженных признаках Qwen3-ASR
Marimba отвечает на ограниченные вопросы о речевом окне: произнесено ли слово, закончилась ли реплика, присутствует ли речь и сколько говорящих слышно. Полезная идея состоит в повторном использовании одного акустического кодировщика, но разные вопросы решаются разными механизмами. Проверка слова всё ещё требует авторегрессионного распознавания; быстрые головы не превращают весь интерфейс в одинаково быстрый универсальный слуховой классификатор.
Метод. Замороженный Qwen3-ASR 0.6B обрабатывает монофоническое окно 16 кГц длительностью до восьми секунд. Для слов получают greedy-транскрипцию и четыре beam-гипотезы, считают долю точных совпадений нормализованного слова и применяют Platt-калибровку. Определение конца реплики использует логистическую голову на признаках слоя 18 с объединением последних двух секунд; дикторские задачи читают слой 12. Голова речевой активности обусловлена вопросом и вариантами ответа. Язык определяется собственными языковыми вероятностями распознавателя, а обнаружение персональных данных использует внешнюю закрытую текстовую систему.
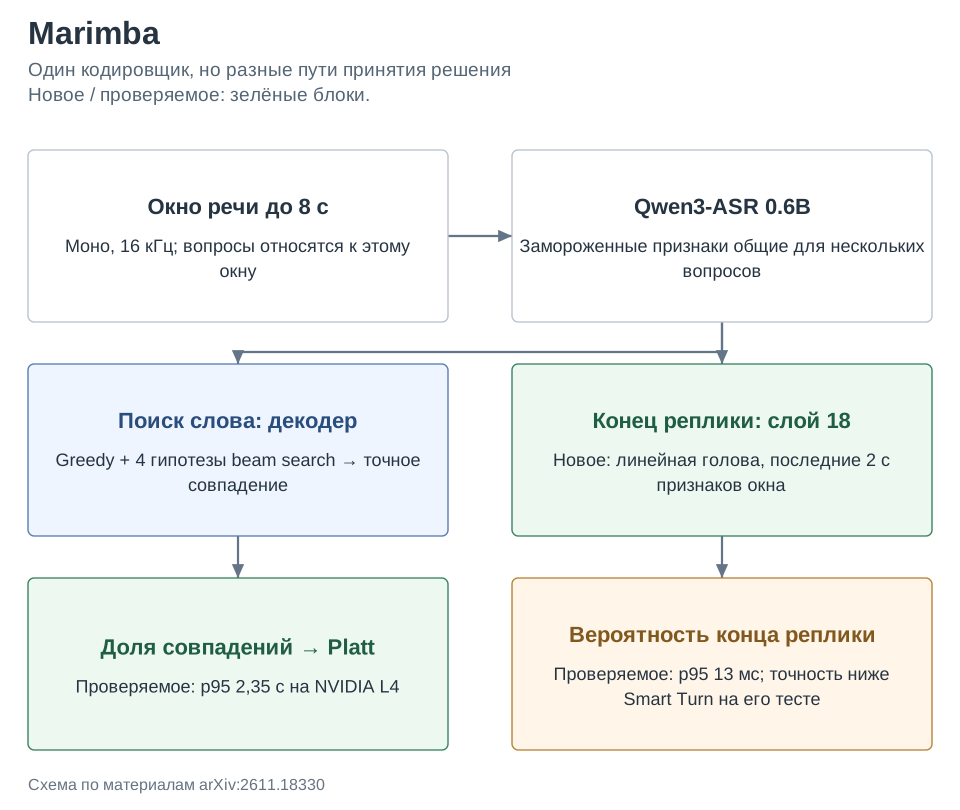
Результаты. Для лексических вопросов AUROC на частных разговорах составляет 0,80–0,92, на Common Voice и FLEURS около 0,92–0,97. Смена диктора имеет AUROC 0,966 на AMI и 0,980 на VoxConverse. Конец реплики на тесте Smart Turn: 0,930 против 0,982 у Smart Turn v3.2; на ICSI 0,716 против 0,712, но доверительный интервал парной разности включает ноль. Это статистически неразличимый результат, а не установленное преимущество.
Ограничения. Значительная часть разговорных данных закрыта. ICSI размечен по следующему говорящему, что не равно смысловой завершённости фразы. На новой задаче классификации сцен точность 0,24–0,29 при случайном уровне 0,25. Модель недосчитывает окна с тремя и более говорящими. Перенос калибровки тоже ограничен: на Smart Turn Platt повышает ECE с 0,034 до 0,041. Повторное использование окна не является доказанным кешированием непрерывного потока.
Фишка из статьи. Измерение p95 на странице 9 отделяет быстрые решения по признакам от медленных проверок содержания. Все строки получены на одной NVIDIA L4, bf16, batch 1 и восьмисекундном контексте, вокруг полного вызова публичного API. Различие почти в два порядка объясняется декодером, а не длиной вопроса.
| Вопрос | p95 полного вызова |
|---|---|
| Конец реплики | 13 мс |
| Речевая активность | 16 мс |
| Язык | 161 мс |
| Наличие слова: greedy + 4-beam | 2,35 с |
Как это читать: 13 мс не означает, что слово можно надёжно проверить за то же время. Таблица измеряет вычисление по уже доступному окну и не включает ожидание будущего речевого контекста. Один проход кодировщика экономит работу между вопросами, но лексическая ветвь сохраняет свою цену.
Источник. Оригинальное название: Marimba: A System One Model for Speech. arXiv:2611.18330; полный текст PDF.