SpheraAudio: пространственный звук и один поток токенов для аудиоязыковой модели
Монофоническая аудиомодель теряет межканальные фазовые отношения, необходимые для направления и взаимного расположения источников. SpheraAudio добавляет отдельную пространственную ветвь, но не сваливает её признаки в общий суммарный вектор: пространственные и содержательные токены образуют временные пары. Работа особенно интересна контрольным сдвигом потоков, который проверяет, действительно ли модель связывает звук конкретного источника с его геометрией.
Метод. AuT обрабатывает log-mel всенаправленного канала, Spatial AuT — действительные и мнимые компоненты четырёхканального STFT. Для FOA используется порядок W,Y,Z,X, для стерео обратимое mid–side-преобразование, для совместимых микрофонных массивов внешняя калибровка в Ambisonics; моно сохраняет исходную ветвь без пространственных токенов. На полный секундный фрагмент приходятся 13 токенов каждой ветви, которые чередуются S1,A1,S2,A2. SMRoPE задаёт общий временной шаг и различие модальностей; при причинном внимании A_t видит S_t, но не наоборот. Пространственный кодировщик предварительно обучают на геометрии, затем выравнивают проекцию и совместно обучают систему с Qwen3-Omni 4B через SFT и RL.
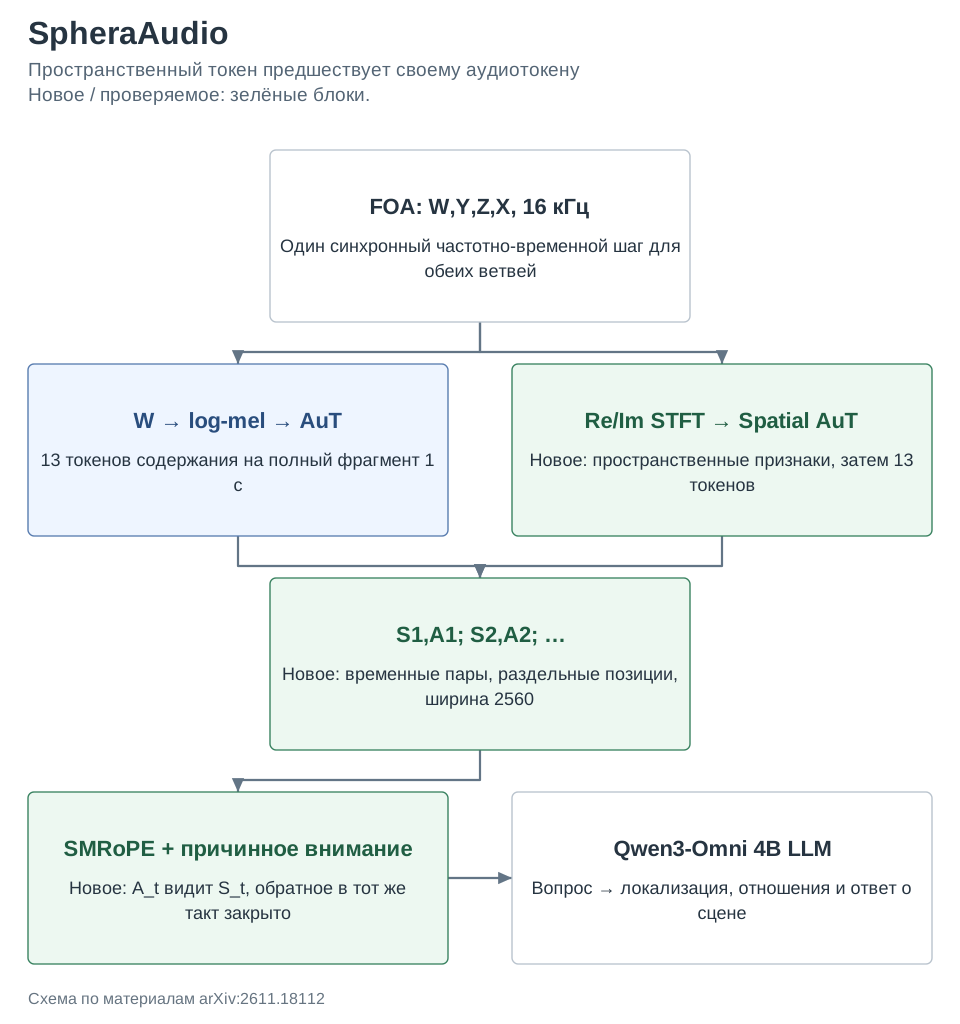
Результаты. На SpheraQA из 20 492 вопросов полная точность ответа равна 60,18% против 41,65% у Spatial-Omni-7B. На TWNM получены 71,70% против 46,20%; на SO-Bench средний балл 66,94 против 64,61. Не все подзадачи улучшены: направление движения на SpheraQA падает с 45,36% до 34,93%. В контроле сложения вместо чередования токенов ошибка азимута составляет 13,47° вместо 4,79°, а CER AISHELL 5,34% вместо 2,81%.
Ограничения. Произвольное число каналов не означает поддержку любого неизвестного устройства без подготовки: массиву нужна калибровка, а старшие порядки Ambisonics сокращаются до первого. Gemini в основном сравнении получает только W, поэтому это не равный многоканальный вход. Стереорезультаты с отдельным SFT нельзя смешивать с простым переносом FOA-модели. У коротких диагностик всего 16 вопросов на условие. Частота 26 токенов на секундный фрагмент — длина входа LLM, не битрейт компрессора и не измеренная задержка.
Фишка из статьи. Таблица 4b меняет согласование потоков у фиксированной модели. Сдвиг только пространственных токенов разрушает соответствие «что звучит — где звучит», а совместный сдвиг сохраняет пары. Такое вмешательство информативнее среднего выигрыша на большом наборе: оно проверяет конкретный механизм связывания признаков.
| Сдвиг при применении | Вопросов | Верное направление названного источника, % |
|---|---|---|
| Без сдвига | 16 | 75,00 |
| Только пространственный поток | 16 | 25,00 |
| Оба потока вместе | 16 | 81,25 |
Как это читать: различие 75% и 81,25% — всего один ответ, поэтому его нельзя считать отдельным улучшением. Существен контраст с 25% при рассогласовании потоков. Это узкий причинный контроль временной привязки, а не статистическая гарантия для всех сцен и микрофонов.
Источник. Оригинальное название: Any Channel Count, One Token Stream: Incorporating Spatial Audio Understanding and Reasoning into Large Audio-Language Models. arXiv:2611.18112; полный текст PDF.