Как язык и речевое задание меняют акустические признаки когнитивных нарушений
Один и тот же акустический признак может быть информативным при чтении и почти бесполезным в свободной беседе. Работа сравнивает пять корпусов на четырёх языках и показывает, почему нельзя без проверки объединять темп, паузы и высоту тона в универсальный показатель. Главный интерес здесь в зависимости признаков от речевого задания, а не в обещании готовой диагностики по голосу.
Метод. После диаризации отделяют речь участника от интервьюера и сохраняют временные метки пауз. Извлекают длительности, темп, eGeMAPS, признаки pyAudioAnalysis и Praat. Затем применяют порог KS ≥0,1, экспертное исключение формантных и сегментных мер, ненадёжных без фонетического выравнивания, и RFECV с Random Forest. В каждом корпусе проводят 20 стратифицированных разбиений 80/20; RFECV выполняется внутри обучающей части. Признак называют устойчивым, если он выбран хотя бы в 80% запусков. Сравнивают английское и китайское описание картинки, испанское чтение, английские воспоминания и японскую беседу.
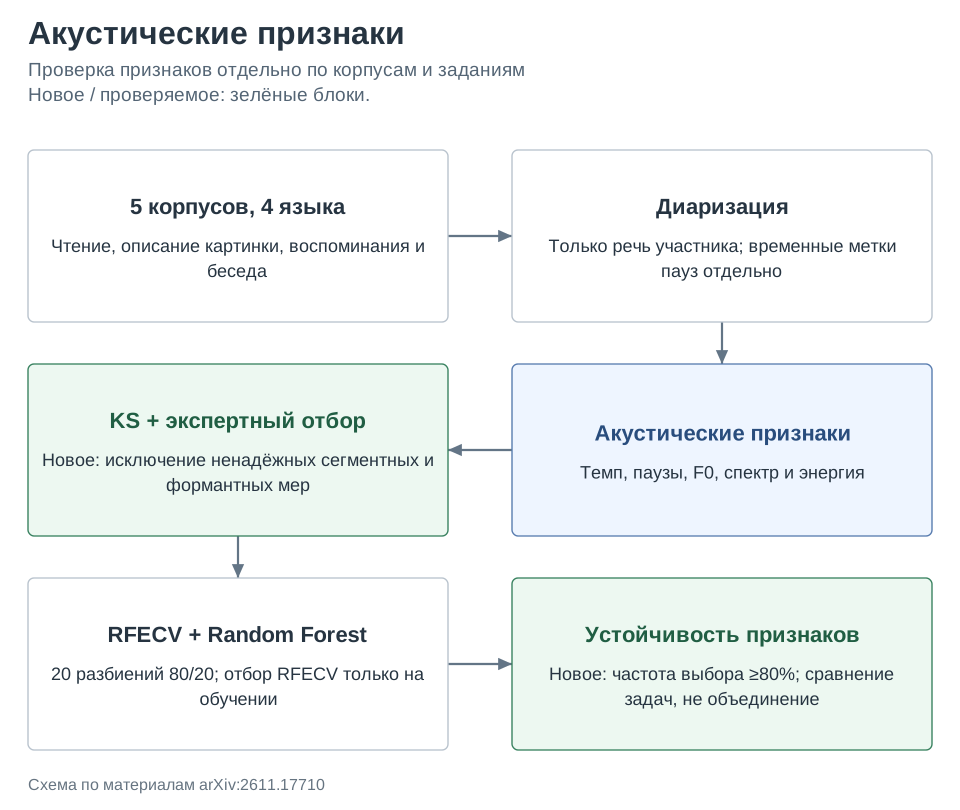
Результаты. Сокращение признаков почти не меняет ROC-AUC: ADReSSo 0,74 → 0,76; Ivanova 0,77 → 0,77; Chou 0,66 → 0,67; PROMPT 0,79 → 0,79; ADRC 0,65 → 0,67. Временные признаки сохраняются во всех корпусах, но темп особенно полезен при заданном внешнем содержании, а в беседе и воспоминаниях больше мешает индивидуальная вариативность. Для китайского и японского сильнее представлены chroma-признаки; в английских и испанском наборах заметнее динамика F0.
Ограничения. Эксперименты выполнены внутри корпусов, а не по схеме обучения на одном языке и проверки на другом. Язык, задание, состав участников и канал записи частично смешаны, поэтому причинный эффект языка не выделен. Вложенность KS-отбора в разбиения описана менее явно, чем вложенность RFECV. В таблицах также различается исходная размерность ADRC; её не следует трактовать как однозначную спецификацию. Полученные AUC не устанавливают клиническую чувствительность или пригодность для самостоятельного диагноза.
Фишка из статьи. Таблица III показывает, сколько признаков можно убрать без видимого выигрыша или проигрыша по средней AUC. Это полезный отрицательный результат против идеи, что более широкий набор акустических мер автоматически надёжнее. Ниже сопоставлены полный набор и KS + эксперт + RFECV; интервалы относятся к повторным разбиениям, а не к внешней клинической проверке.
| Корпус | Полный набор: число / AUC | После отбора: число / AUC |
|---|---|---|
| ADReSSo | 255 / 0,74 | 142 / 0,76 |
| Ivanova | 255 / 0,77 | 114 / 0,77 |
| Chou | 255 / 0,66 | 106 / 0,67 |
| PROMPT | 262 / 0,79 | 101 / 0,79 |
Как это читать: почти 60% признаков PROMPT можно убрать при той же средней AUC. Но компактный набор в одном корпусе не становится автоматически переносимым: для такого вывода нужен независимый межкорпусный тест с контролем задания и канала.
Источник. Оригинальное название: Cross-Linguistic Acoustic Biomarkers of Cognitive Impairment Across Interactive and Single-Speaker Speech Tasks. arXiv:2611.17710; полный текст PDF.