Что многоязычные самообученные речевые кодировщики знают о смысле предложения
Из речевого представления можно извлечь смысл предложения, но хорошее качество внутри языка не гарантирует переноса на другой. Авторы проверяют девять самообученных кодировщиков и их варианты после обучения распознаванию на 76 языках. Особенно полезно разделение доступности смысла линейной пробе, общей межъязыковой структуры и акустических подсказок одного диктора.
Метод. Речевые кодировщики и текстовый SONAR заморожены. Пробу обучают отображать усреднённые по времени признаки выбранного слоя в пространство английских переводных текстов; качество — top-1 поиска правильного текста по косинусному сходству. Используются FLEURS с разными говорящими и записи Нового Завета с одним диктором на язык. Сравнивают отдельную пробу на языке, общую многоязычную и leave-one-language-out, где язык исключён только из обучения пробы. Дополнительные контроли вводят внимание при объединении кадров, малый ранг проекции, центрирование по языку и удаление имён из текстов.
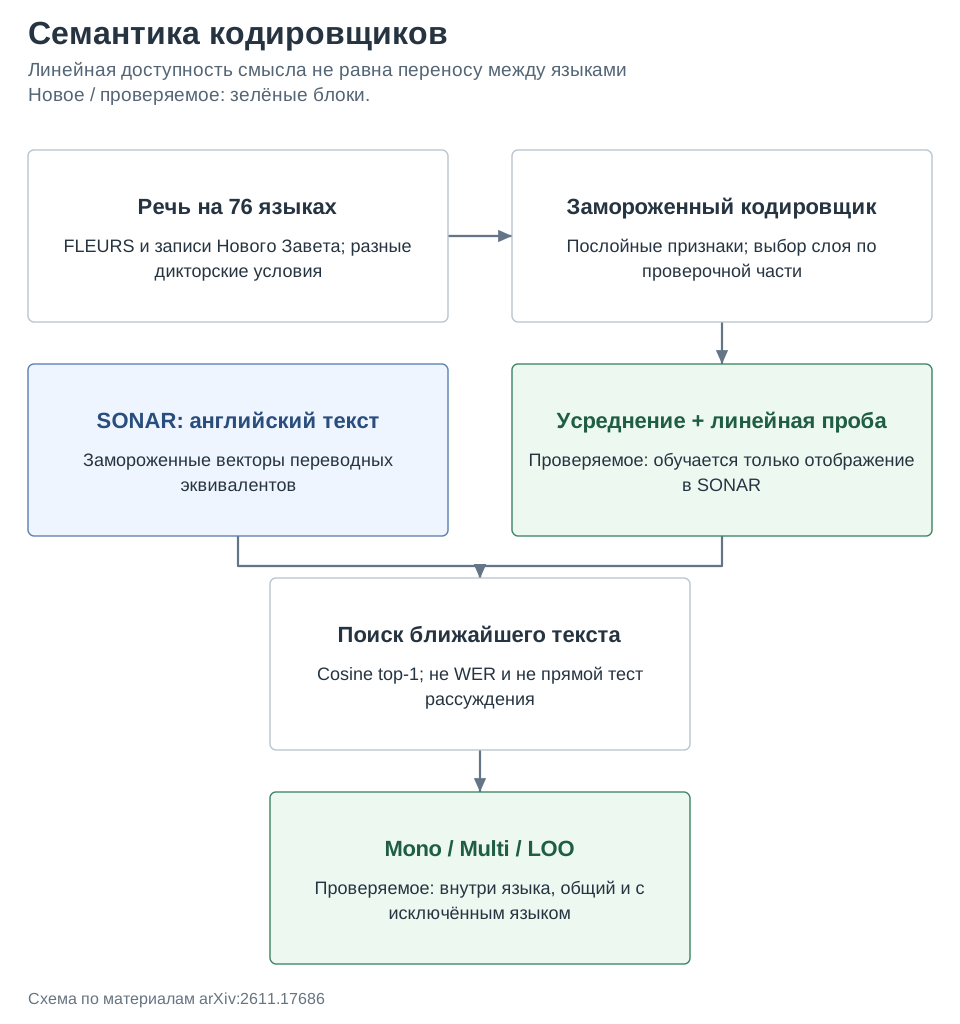
Результаты. На FLEURS w2v-BERT-2.0 с 580 млн параметров достигает 47% многоязычного top-1, превосходя значительно более крупный OmniASR-W2V-7B. У последнего leave-one-out даёт 33% против 30% отдельной пробы, а XEUS падает с 33% до 15%. После обучения распознаванию OmniASR-7B LLM достигает 82% внутри языка, но только 57% при LOO. Внимание вместо среднего увеличивает отдельные показатели MMS с 26% до 44%, w2v-BERT-2.0 с 36% до 52%; это отдельный эксперимент, не числа основной многоязычной таблицы.
Ограничения. Поиск переводного текста не является прямым доказательством языкового рассуждения. Модели различаются не только размером, но данными и целями предобучения; их причинный вклад не изолирован. Высокие результаты одно-дикторских религиозных записей могут использовать канал и акустику. LOO не означает, что язык отсутствовал в предобучении кодировщика. Основной протокол усредняет кадры, а внимание проверено не во всех режимах. Научная интерпретация ограничена тем, что доступно сравнительно простой пробе.
Фишка из статьи. Рисунок 5 показывает, кому достаётся выигрыш масштабирования внутри одной семьи OmniASR-W2V. Размер растёт с 300M до 7B, но прирост top-1 для малоресурсных языков почти на порядок меньше по процентным пунктам, чем для высокоресурсных. Это конкретный пример того, как среднее улучшение скрывает растущий разрыв.
| Ресурсная группа FLEURS | 300M, top-1, % | 7B, top-1, % | Изменение, п.п. |
|---|---|---|---|
| Высокоресурсная | 14 | 68 | +54 |
| Среднересурсная | 7 | 22 | +15 |
| Малоресурсная | 6 | 12 | +6 |
Как это читать: увеличение модели само по себе не выравнивает языки. Таблица относится к монолингвальным пробам на FLEURS; её нельзя подменять многоязычными или LOO-оценками. Для выбора кодировщика под новый язык разумнее измерить нужный режим переноса и слой, чем ориентироваться только на число параметров.
Источник. Оригинальное название: What Do Multilingual Self-Supervised Speech Encoders Know About Sentence Meaning?. arXiv:2611.17686; полный текст PDF.