CoTTAGE: объяснимая оценка звука, сгенерированного по описанию
Совпадение звука с текстом и качество самого звука — разные свойства: запись может точно передавать событие, но содержать сильные искажения. CoTTAGE учится оценивать их раздельно и перед баллом выдаёт объяснение слышимых недостатков. Помимо оценщика, вклад работы — 10 362 фрагмента с новыми человеческими оценками общего качества, которых нельзя надёжно заменить сходством CLAP или эстетической привлекательностью.
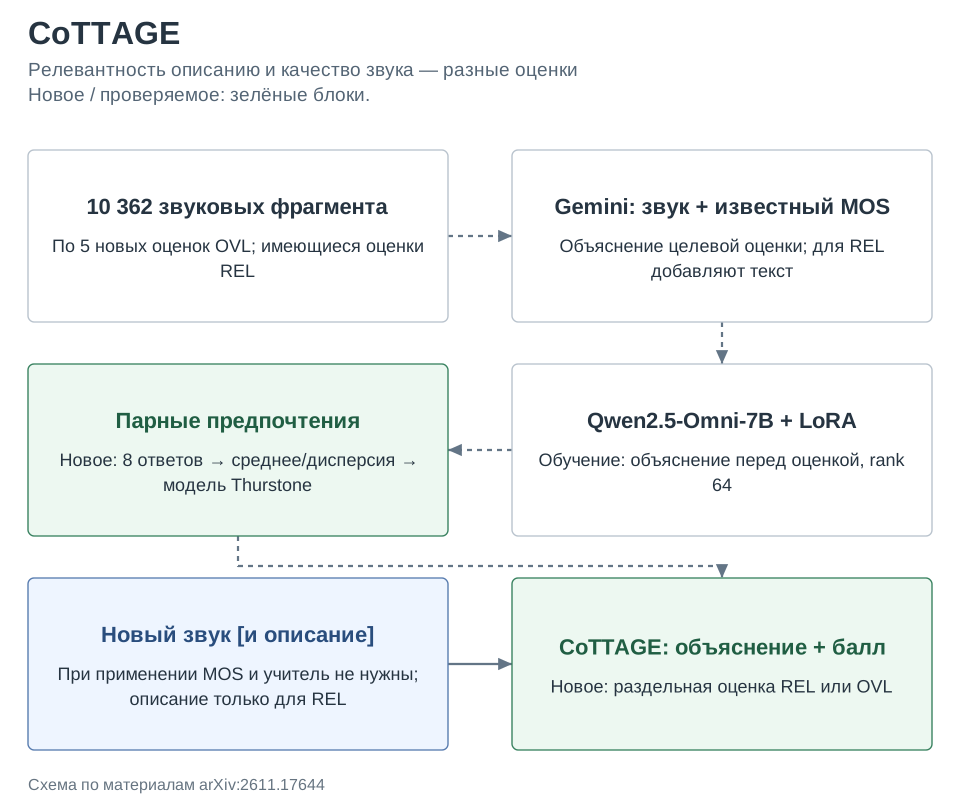
Метод. Для каждого фрагмента RELATE и XACLE собирают пять оценок OVL; оценки соответствия тексту REL уже доступны. Gemini-3.1 Pro получает звук и известный человеческий MOS и составляет обучающее объяснение; текст добавляется только для REL. Qwen2.5-Omni-7B обучают с LoRA rank 64 сначала на таких объяснениях и баллах, затем через GRPO. На второй стадии по восьми ответам оценивают среднее и дисперсию баллов, модель Thurstone переводит их в вероятности парных предпочтений. Награда по коэффициенту Бхаттачарьи согласует их с порядком человеческих MOS; отдельная награда следит за форматом. При применении MOS и учитель не нужны.
Результаты. Для REL корреляция Pearson составляет 0,685 на XACLE против 0,472 у CLAPScore и 0,601 у варианта без RL. На RELATE результат равен 0,594, на PAM-Audio 0,657, на Clotho 0,607. Для OVL получены 0,611 на PAM-Audio и 0,559 на Clotho; это корреляции с человеческими оценками, не точность обнаружения каждого дефекта. Публикуется медианный результат трёх случайных инициализаций. В слепом сравнении объяснений с Qwen2.5-Omni выигрыш без ничьих составляет 75,7% для REL и 63,4% для OVL.
Ограничения. Основная область — короткие окружающие звуки, преимущественно менее 30 секунд, а не полноценная проверка музыки, синтеза речи или неанглийских инструкций. Объяснения не содержат точных временных меток дефектов. Человеческая проверка объяснений охватывает 50 примеров и трёх оценщиков; преимущество над сильным учителем по OVL невелико. Рассуждение учителя, уже знающего MOS, не является независимым доказательством причины оценки. Оптимизация генератора только под этот оценщик может привести к подгонке под метрику.
Фишка из статьи. Рисунок 4 позволяет увидеть, насколько способ подсчёта меняет впечатление от качества объяснений. При сравнении с Gemini преимущество OVL без ничьих равно 53,4%, однако из всех голосов CoTTAGE выигрывает лишь 36,7%, а 31,3% заканчиваются ничьей. Это гораздо более сдержанный результат, чем общее утверждение о предпочтительности объяснений.
| Критерий против Gemini | CoTTAGE лучше, % | Ничья, % | Gemini лучше, % | Выигрыш без ничьих, % |
|---|---|---|---|---|
| REL | 54,0 | 17,3 | 28,7 | 65,3 |
| OVL | 36,7 | 31,3 | 32,0 | 53,4 |
Как это читать: объяснения соответствия описанию выигрывают заметнее, чем объяснения качества. Исключение ничьих отвечает на другой вопрос, чем доля всех предпочтений; оба показателя нужны, особенно при небольшой человеческой выборке. Это не отменяет корреляционных результатов, но ограничивает вывод о превосходстве объяснений.
Источник. Оригинальное название: CoTTAGE: An Explainable Judge for Text-to-Audio Generation. arXiv:2611.17644; полный текст PDF.