CamSpokenNLI: речевой пилот для камерунского пиджина и Camfranglais с проверкой утечек
CamSpokenNLI соединяет короткие речевые посылки с текстовыми гипотезами для двух языковых вариантов Камеруна. Ценность небольшого пилота не в высокой точности: автор показывает, как общие сценарии и формулировка гипотез могут создать ложное впечатление смыслового переноса. Проверка Whisper идёт отдельной ветвью и выявляет серьёзные ошибки выбора языка даже на короткой чистой записи.
Метод. В каждом варианте 114 заданий с равными классами следования, противоречия и нейтральности; сценарии и метки попарно совпадают. Один автор составляет, записывает и размечает материал. Текстовый XLM-RoBERTa-base получает эталонные посылку и гипотезу; при перекрёстной проверке по пяти общим группам номер тестового сценария исключается из обучения в обоих вариантах. Проверяются также только гипотеза, только посылка и контроль с полным исходным набором, заведомо содержащим аналоги тестовых заданий. Отдельно Whisper Base, Small и Large-v3 распознают 228 монофонических записей 16 кГц с автоматическим либо принудительным английским/французским языком.
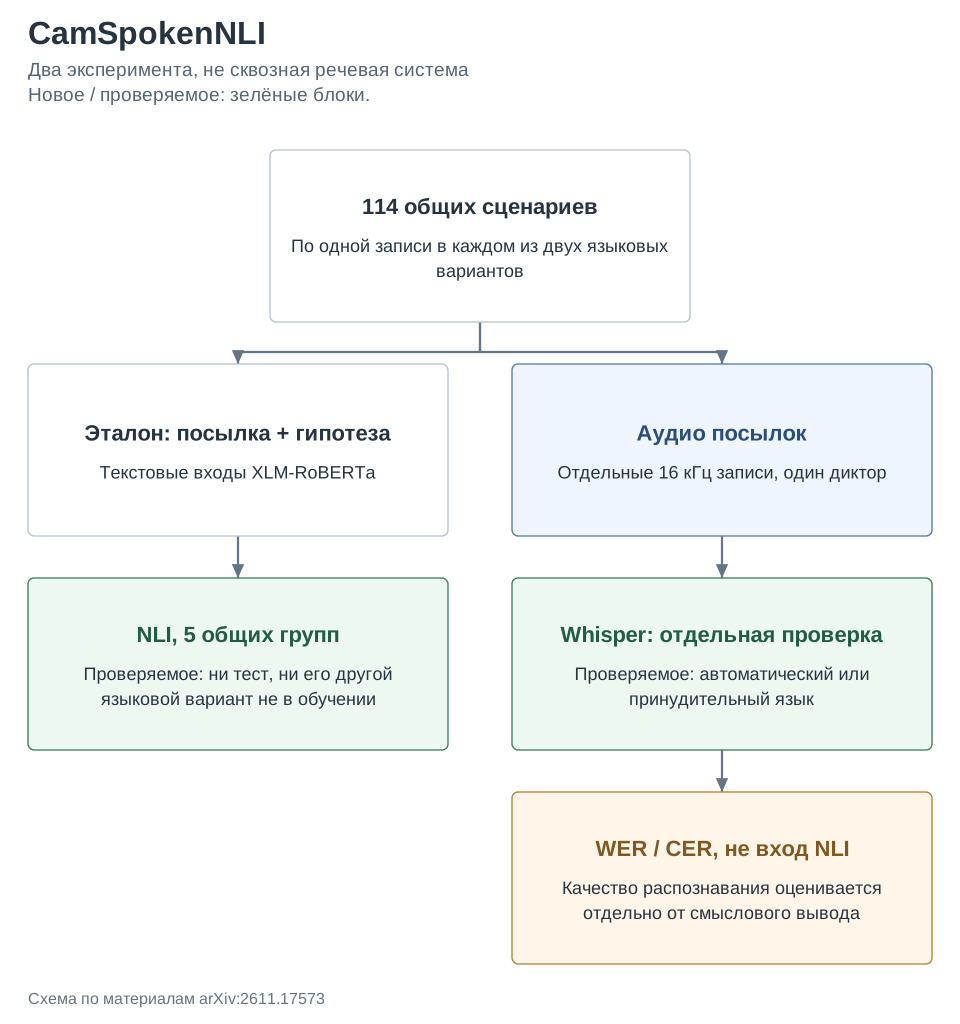
Результаты. Точность NLI внутри вариантов составляет 44,7% и 46,2% при случайных 33,3%. Но только гипотеза даёт 41,8% и 47,1%; парные тесты не устанавливают различия. При переносе без общих тестовых сценариев получены 40,1% в Camfranglais и 45,6% в пиджин. У Whisper Large-v3 автоматический выбор языка даёт WER 80,6% и 64,9%; принудительный подходящий язык снижает их до 66,6% и 45,5%. Для пиджина 93 из 114 записей Large-v3 помечает как Yoruba или Swahili.
Ограничения. Это один диктор, один разметчик и 114 общих сценариев, без независимой оценки согласия разметки. Нет отдельной окончательной тестовой части; параметры частично выбирались в предварительных опытах. Три инициализации обучаются на тех же заданиях и не дают трёх независимых выборок. WER чувствителен к нестандартному написанию. Текстовый NLI не получает ни аудио, ни вывод Whisper, поэтому работа не измеряет распространение ошибок распознавания в смысловой вывод.
Фишка из статьи. Рисунок 3 и раздел 4.3 сравнивают корректный перенос с проверкой утечки. Если обучить модель на всех заданиях исходного варианта, она уже видела смысловой аналог каждого тестового примера на другом языке, и результат резко растёт. При этом меняется и объём обучения: 114 вместо 91–92 примеров; всё увеличение нельзя приписать только утечке.
| Направление | Непересекающиеся сценарии, % | Полный исходный набор с аналогами теста, % |
|---|---|---|
| Пиджин → Camfranglais | 40,1 ± 3,3 | 63,7 ± 5,3 |
| Camfranglais → пиджин | 45,6 ± 3,5 | 60,5 ± 8,0 |
Как это читать: это аудит протокола, а не два равноправных результата переноса. Общие переводы и сценарии нужно исключать на уровне идентификатора смысла, даже если тексты сильно различаются. Дополнительный контроль только гипотезы не позволяет объявить оставшиеся 40–46% доказанным переносом способности рассуждать.
Источник. Оригинальное название: CamSpokenNLI: A Pilot Resource for Cross-Variety Transfer Evaluation in Cameroon Pidgin English and Camfranglais. arXiv:2611.17573; полный текст PDF.