Kezek: отдельные дорожки двух собеседников из монофонического разговора
Короткое «да» на фоне длинной фразы другого человека легко исчезает после разделения речи. Kezek решает именно задачу двух собеседников: сначала устанавливает их личности и активность по всей записи, затем разделяет смесь с этими подсказками. Работа полезна не только итоговыми числами, но и подробной картой случаев, где сохранение тихих реплик всё ещё не удаётся.
Метод. Первая стадия объединяет акустический отпечаток диктора и PairNet, получая два глобально согласованных профиля и две дорожки активности. Вторая стадия, разделитель на основе Conv-TasNet с 19,6 млн параметров, обрабатывает восьмисекундные фрагменты с этими условиями. Всего собственные модули содержат около 41 млн параметров. Выходные дорожки в точности складываются в исходную смесь: yA + yB = x. Это не восстановление чистой речи без шума; цель состоит в правильном распределении записи между участниками без перестановок их личности.
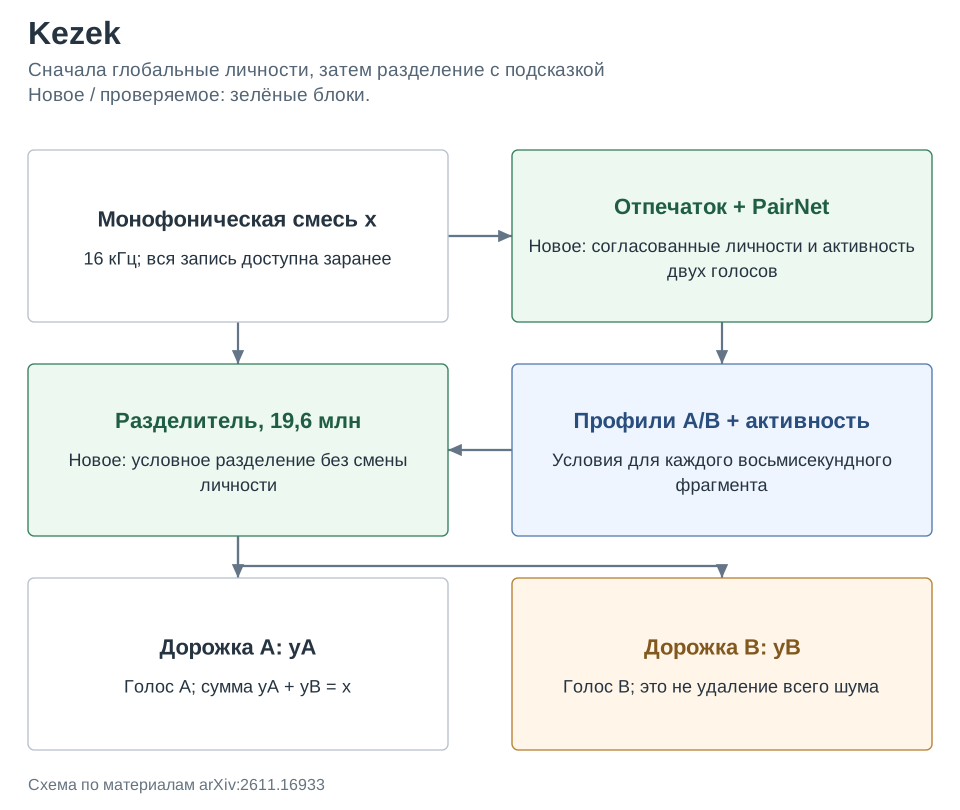
Результаты. На 121 разговоре OpenYap, ограниченном первыми 300 секундами, доля сохранённых коротких ответов по энергетическому критерию повышается с 0,687 у цепочки pyannote + DialogueSidon до 0,830. Утечка чужого голоса снижается с -10,1 до -13,9 дБ, покрытие сессий возрастает с 0,735 до 1,000. На RTX PRO 6000 скорость составляет 231 час аудио на час GPU против 51. Но на общей части возвращённого обоими методами материала сохранность почти одинакова: 0,865 против 0,859. Поэтому важная доля преимущества связана с покрытием, а не с безусловно лучшим разделением каждого фрагмента.
Ограничения. Система рассчитана на двух говорящих, использует всю запись и не является потоковым разделителем. Основные данные английские; OpenYap участвовал в разработке, а CallHome не предоставляет идеальных раздельных дорожек для всех измерений. Работа также показывает чувствительность отпечатков к фазе: телефонная IIR-фильтрация может вредить сильнее фильтра с нулевой фазой, а фазовые аугментации помогают. Это смежный с фазовой обработкой результат, но не отдельный алгоритм фазового улучшения речи.
Фишка из статьи. Таблица 9 проверяет не только присутствие, но и слышимость ответа. На 20 проверочных разговорах для реплик более чем на 10 дБ тише другого голоса даже правильная активность не спасает разделитель. Это существенно строже энергетического критерия из основного теста.
| Метод | Ответ громче другого | От 0 до -10 дБ | Ниже -10 дБ |
|---|---|---|---|
| Kezek | 0,965 | 0,827 | 0,171 |
| Разделитель + эталонная активность | 0,947 | 0,865 | 0,286 |
| Идеальная относительная маска | 1,000 | 1,000 | 0,743 |
Как это читать: основной провал находится в очень тихих наложенных репликах, а не просто в ошибке определения активности. Даже идеальная маска не даёт единицу в самом трудном диапазоне. Эти числа нельзя напрямую сравнивать с 0,830 выше: отличаются часть данных и определение сохранённого ответа. Увеличение разделителя с 19,6 до 26 млн параметров почти не меняет SI-SDRi, поэтому рост размера сам по себе не решает проблему.
Источник. Оригинальное название: Kezek: Splitting Mono Two-Person Conversations into Per-Speaker Tracks for Full-Duplex Dialogue Data. arXiv:2611.16933; полный текст PDF.