MESH: пространственное слушание в движущейся группе приёмников
Аудиомодель может правильно расшифровать смесь, но выбрать не того говорящего или перепутать локальные и мировые координаты. MESH проверяет эти ошибки в моделируемых помещениях с несколькими приёмниками, движением и реверберацией. Главная ценность набора не в едином итоговом балле, а в разделении того, какие записи и пространственные сведения реально доступны системе.
Метод. SoundSpaces 2 формирует импульсные характеристики помещений и их меняющиеся во времени варианты. Из 800 исходных сцен в 100 комнатах получают 800 статических и 1 600 динамических реализаций, 4 761 запись FOA и около 40 тыс. вопросов по 13 задачам. Источники используют 300 дикторов LibriSpeech. В эгоцентрическом режиме доступны собственное аудио и метаданные соседей, но не их звук; в аллоцентрическом доступны все синхронизированные записи и позы приёмников. Вход FOA имеет частоту 16 кГц и порядок каналов W,Y,Z,X с нормировкой ACN/SN3D.
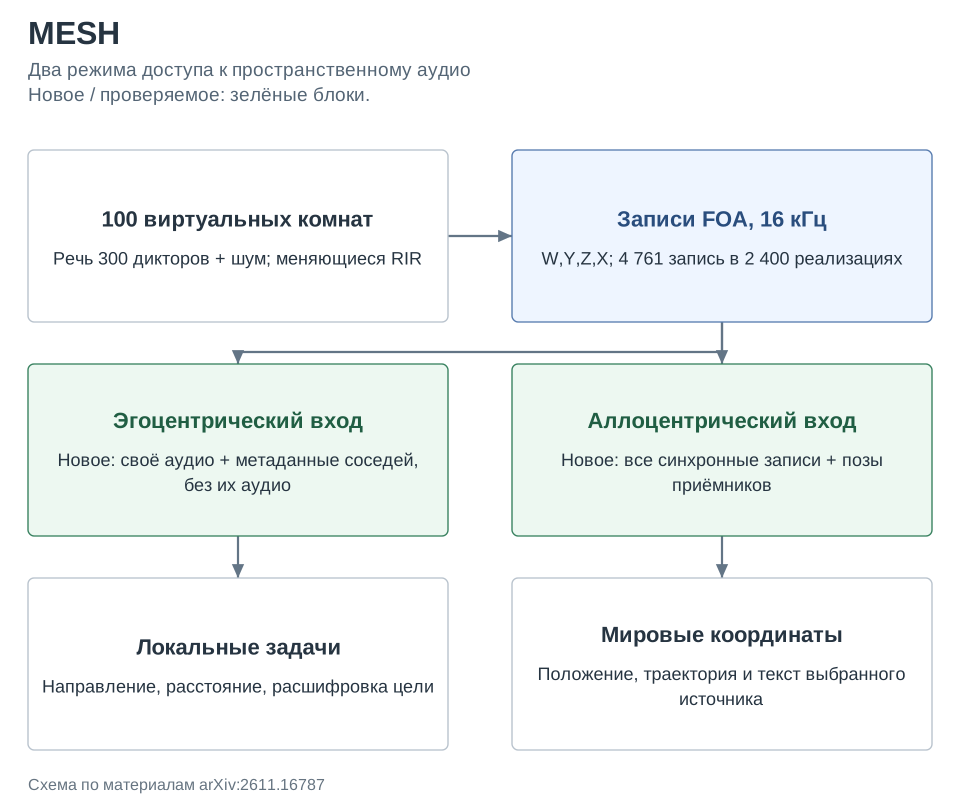
Результаты. Даже сильные модели далеки от надёжного пространственного слушания: например, Qwen3.8-Omni-Flash получает 41,54% в динамической задаче направления, а лучшая указанная конфигурация Qwen3.5-Omni-Plus с раздельными FOA-каналами лишь 21,90% в статической оценке расстояния. В 25,68% положительных ответов этой конфигурации расшифровка оказывается ближе к речи другого участника, чем к нужной цели. MESH-agent достигает WER 59,15% в основном тесте динамической аллоцентрической расшифровки; это ещё не пригодное для надёжного применения качество.
Ограничения. Это симуляция с известными позами, синхронизацией и идеальным удалением собственного воспроизведения. Движение горизонтальное, высота и ориентация фиксированы, точный эффект Доплера не воспроизводится. Результат нельзя без дополнительного опыта переносить на реальные роботы и микрофонные решётки. Показатели задач имеют разные определения, а диагностический development holdout из приложения не совпадает с основным тестом.
Фишка из статьи. В таблице 6 приложения агент сравнивается с фиксированной цепочкой MVDR при одних и тех же наблюдениях специализированных модулей. Сложный планировщик не выигрывает. Это редкий полезный контроль: он отделяет наличие хороших инструментов от пользы многократного выбора их порядка языковой моделью.
| Development holdout | Метрика | MESH-agent | Фиксированный MVDR |
|---|---|---|---|
| Статическое расстояние ES-CDist | RelAcc@20%, выше лучше | 19,19 | 20,35 |
| Статическая расшифровка ES-Trans | WER, %, ниже лучше | 116,16 | 91,69 |
| Динамическая расшифровка AD-Trans | WER, %, ниже лучше | 82,64 | 69,90 |
Как это читать: на этой отдельной проверочной части планирование не окупается. Это не доказательство бесполезности всех агентов: сравнение ограничено конкретными инструментами и задачами. WER выше 100% допустим из-за вставленных слов. Последнюю строку нельзя смешивать с 59,15% на основном тесте: разделы данных различаются.
Источник. Оригинальное название: MESH: Multi-receiver Evaluation of Spatial Hearing across Egocentric and Allocentric Views. arXiv:2611.16787; полный текст PDF.