Утечка речи через сочетание акустических признаков: RMS, высота тона и сглаженная спектрограмма
Удаление подробной спектрограммы ещё не делает запись признаков безопасной. Авторы проверяют, сколько речи и сведений о дикторе остаётся в огибающей RMS, высоте тона и грубо сглаженных мел-признаках. Главный вывод касается сочетаний: два по отдельности бедных представления могут восстанавливать взаимно недостающую информацию.
Метод. Исходные 80 мел-полос вычисляются с окном 25 мс и шагом 12,5 мс. Для защищённого варианта спектральную мощность рекурсивно сглаживают с постоянной 500 мс и прореживают в 40 раз; кадры повторяют для совмещения с исходным шагом. RMS и YIN-оценка тона 80–400 Гц сохраняют другую временную информацию. Для каждого набора признаков заново обучают осведомлённые модели: распознаватель текста, проверку диктора, определение речевой активности и диаризацию. Это важнее проверки готовой сети на непривычном входе, которая могла бы ошибочно показать отсутствие утечки.
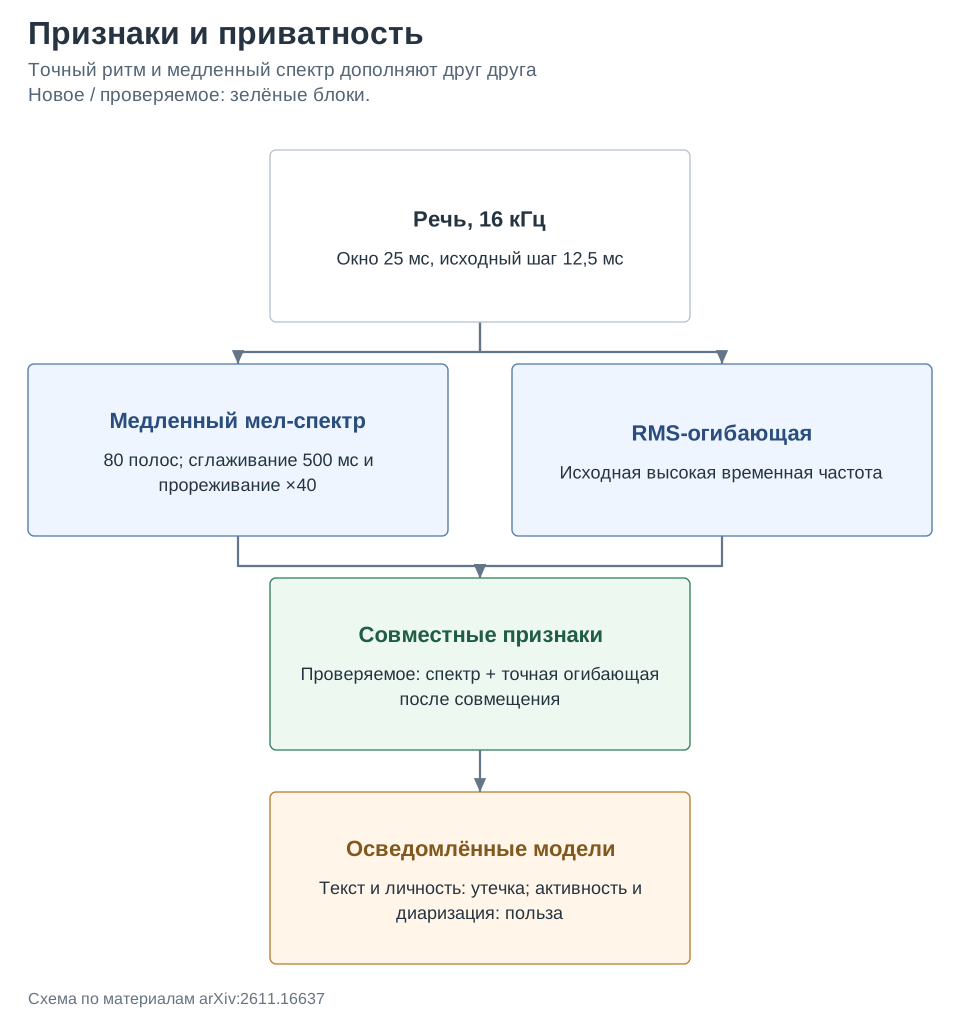
Результаты. По одному RMS распознаватель получает WER 61,67% на LibriSpeech test-clean; 2,71% фраз восстанавливаются целиком, включая отдельные предложения до 22 слов. Сочетание RMS со сглаженной спектрограммой уменьшает WER до 23,54%, то есть резко ухудшает защиту содержания. При шуме 10 и 5 дБ WER по RMS возрастает до 89,69 и 100,85%. Высота тона сама по себе даёт WER выше 100%, но не является надёжной защитой личности: ошибки проверки диктора остаются заметно ниже случайного уровня. Для речевой активности модель по тону имеет MCC 0,53.
Ограничения. WER и EER здесь эмпирические признаки утечки, а не математическая гарантия приватности. Основная опасность показана на чистой речи; шум, реверберация и перекрытия требуют отдельной проверки. Диаризация AMI использует эталонную речевую активность. Проверка личности обучена на 360 часах LibriSpeech с 921 диктором, что ограничивает перенос к более сильным моделям. Подробная временна́я сетка признаков сохраняет информацию даже при нормализации общего уровня записи.
Фишка из статьи. В разделе 3 и на рисунке 3 RMS оказывается гораздо информативнее ожидаемого. Ниже приведён контроль одной и той же формы признака при меняющейся акустике, а также его объединение с медленным спектром. Меньший WER здесь означает не преимущество защиты, а более серьёзную утечку текста.
| Доступные признаки и условия | WER, % | Что показывает опыт |
|---|---|---|
| Только RMS, чистая речь | 61,67 | Даже огибающая передаёт часть содержания |
| Только RMS, шум 10 дБ | 89,69 | Утечка зависит от акустических условий |
| Только RMS, шум 5 дБ | 100,85 | Большое число ошибок и вставок |
| Мел-спектр 500 мс + RMS, чистая речь | 23,54 | Сочетание восстанавливает недостающие сведения |
Как это читать: высокую ошибку одного признака нельзя использовать как сертификат безопасности всего набора. Добавление точной огибающей улучшает полезное определение активности, но одновременно помогает восстанавливать слова. Сглаживание и RMS до 250 мс подавляет этот выигрыш в распознавании, однако ожидаемая польза для активности также исчезает: бесплатного компромисса в этом опыте не получилось.
Источник. Оригинальное название: The Unseen Threat: How Complementary Combinations of Acoustic Features Compromise Speech Privacy. arXiv:2611.16637; полный текст PDF.