SSC: структурированное описание дикторов для распознавания целевой речи
Для распознавания выбранного участника встречи недостаточно знать, говорит ли сейчас «кто-то другой». SSC сохраняет отношения между конкретными дорожками активности и акустические признаки их дикторов. Вторая часть идеи меняет не просто размер управляющей сети, а способ воздействия на каналы акустического кодировщика.
Метод. RSC извлекает признаки личности по полной записи и диаризации. TCRE объединяет историю активности цели, отдельных мешающих участников и их пар, сохраняя симметрию к перестановке дорожек; причинные свёртки используют 210 мс истории. Полученное условие управляет CLRM: диагональная модуляция FiLM дополняется межканальной поправкой ранга 8. Это позволяет передавать не только громкость отдельных каналов, но и зависящие от диктора сочетания каналов. Полносессионный RSC и локальный причинный TCRE имеют разные временные ограничения.
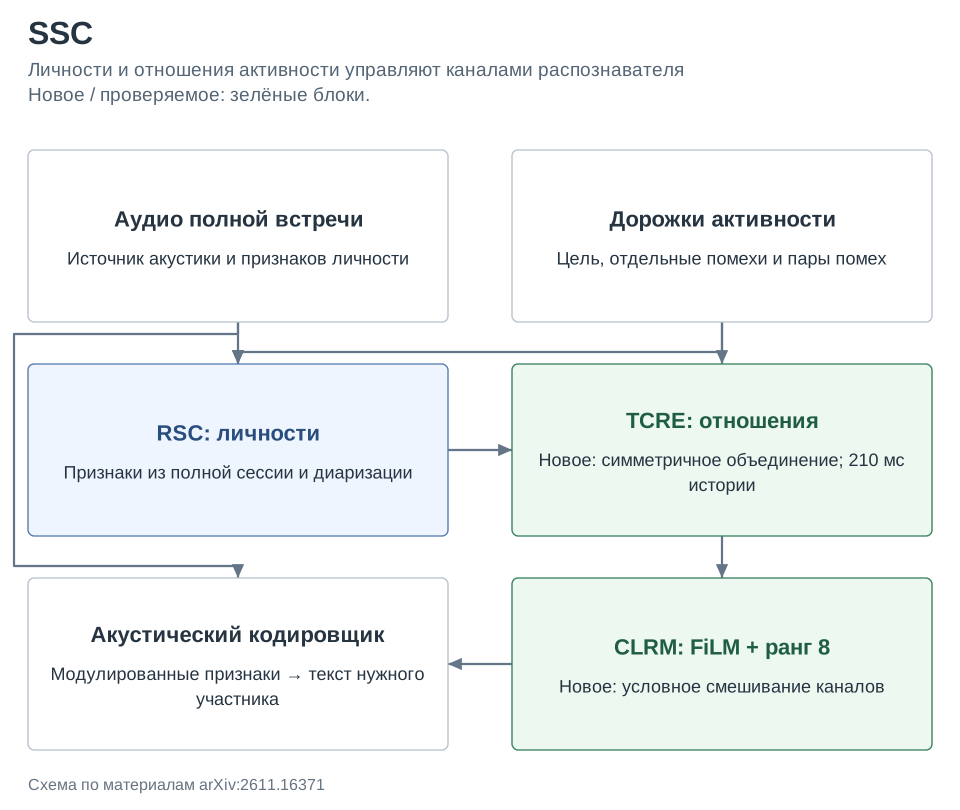
Результаты. В контроле на Qwen3-ASR-0.6B с эталонной диаризацией полный SSC снижает cpER с 17,92 до 16,47% на AliMeeting, с 13,20 до 12,86% на AISHELL-4, с 18,35 до 17,19% на AMI-SDM и с 21,36 до 19,67% на NOTSOFAR-1. Среднее относительное сокращение ошибки по четырём корпусам составляет 6,23%. Число параметров управления 1,46 млн. В полном комплексе авторы дополнительно используют другие распознаватели и обучение GSPO, поэтому его большие межсистемные выигрыши нельзя приписать только одному блоку SSC.
Ограничения. Эталонная диаризация из компонентного эксперимента недоступна обычному приложению. Ошибки реального разделения на дикторов и полнота их акустических образцов остаются существенными зависимостями. История TCRE в 210 мс не делает всю систему потоковой: RSC использует полную сессию. Сравниваемые комплексные системы имеют неодинаковые внешние данные и исходные модели, а не все улучшения по отдельным корпусам статистически подтверждены.
Фишка из статьи. Таблица II проверяет соблазнительное объяснение «достаточно увеличить сеть». При неизменных отношениях активности TCRE третьего порядка более крупный FiLM64 уступает компактной межканальной модуляции. Последняя строка отдельно добавляет признаки личности RSC.
| Управление | Параметры, млн | Среднее RER, % |
|---|---|---|
| TCRE + FiLM | 1,13 | 2,84 |
| TCRE + FiLM64 | 2,23 | 0,92 |
| TCRE + CLRM8 | 1,43 | 3,90 |
| TCRE + CLRM8 + RSC | 1,46 | 6,23 |
Как это читать: RER здесь относительное уменьшение cpER против STNO-FDDT, усреднённое с равным весом корпусов, при эталонной диаризации. Большее число параметров само по себе не помогает: важны тип канального взаимодействия и сведения о личности. Значение 6,23% не означает уменьшение абсолютного WER на 6,23 процентного пункта.
Источник. Оригинальное название: Structured Speaker Conditioning for Diarization-Guided Target-Speaker ASR. arXiv:2611.16371; полный текст PDF.