Похожесть на человека и желание продолжать разговор: разные критерии оценки синтеза
Голос, который звучит более по-человечески, не обязательно приятнее как собеседник. Авторы дают двум группам слушателей одни и те же реплики, но задают разные вопросы: о похожести на человека и о предпочтении для разговора. Это управляемая проверка цели оценки синтеза, а не новый генератор речи.
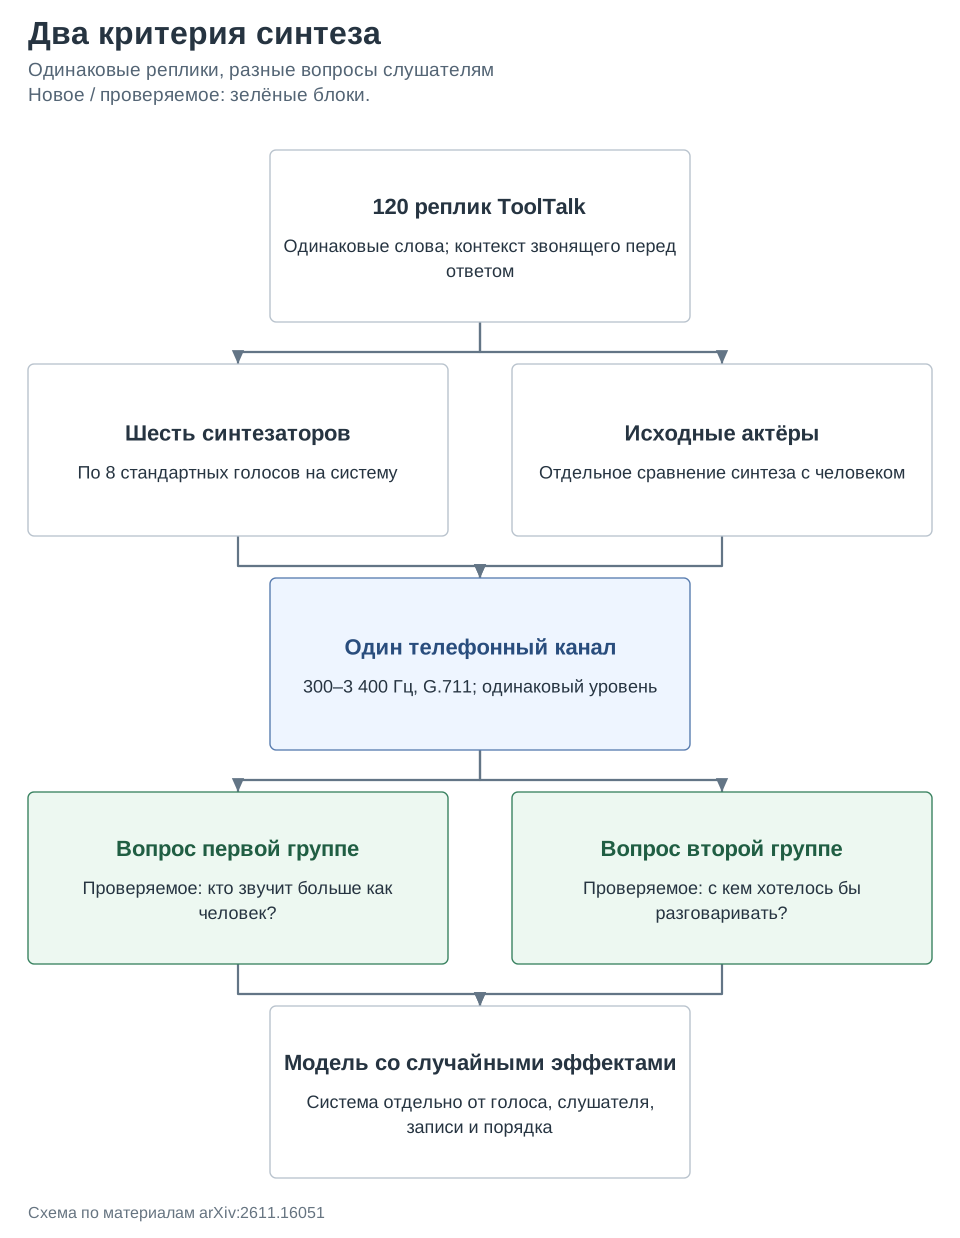
Метод. Из ToolTalk берут 120 реплик обслуживания клиентов по 8–30 слов и синтезируют их шестью системами, по восемь стандартных голосов в каждой. Перед ответом воспроизводится контекст звонящего. Все записи проходят один телефонный канал 300–3 400 Гц, G.711 μ-law 8 кГц и нормализацию уровня; различия текста исключены. Первый опыт сравнивает системы между собой, второй с исходными актёрами. После контроля качества остаются 654 слушателя и 19 517 суждений. Логистическая модель со случайными эффектами отделяет систему от голоса, конкретной записи, слушателя и порядка предъявления.
Результаты. Ранжирования по двум вопросам не пропорциональны: χ²(4) = 25,6, p < 0,001. Вероятность выбрать Rime против средней системы меняется с 68% по похожести на человека до 49% по разговорному предпочтению, а Google с 33 до 49%. Против актёров все системы уступают в похожести; средняя вероятность выбора синтеза 19%, но в разговорном предпочтении она уже 36%. Cartesia получает 49% против актёра с 95%-м интервалом 42–57%: в этих условиях она сопоставима по предпочтению, хотя не по похожести.
Ограничения. Это англоязычные короткие реплики в телефонном канале и оценки американских слушателей, а не интерактивный разговор с работающим агентом. Синтезаторы получают текст человеческих ответов без контекста и инструкций подачи. Связи просодии с выбором корреляционные: эксперимент не доказывает, что простое ускорение любой речи причинно улучшит впечатление. Разброс голосов велик, поэтому сравнение одного произвольно выбранного голоса не характеризует всю систему.
Фишка из статьи. В разделе 3.4 и на рисунке 3 автоматические оценки ведут себя не так, как ожидается от измерителя естественности. Эффект сохраняется и до имитации телефонного канала. Ниже указано направление статистической связи, а не придуманные коэффициенты корреляции.
| Автоматическая оценка | Похожесть на человека | Предпочтение для разговора |
|---|---|---|
| UTMOS | Более высокая оценка связана с меньшим выбором | Надёжная связь не обнаружена |
| UTMOSv2 | Более высокая оценка связана с меньшим выбором | Надёжная связь не обнаружена |
| NISQA naturalness | Надёжная связь не обнаружена | Надёжная связь не обнаружена |
Как это читать: во всём этом наборе автоматические оценки ставят актёров ниже каждой системы, хотя люди считают актёров наиболее человекоподобными. Значит, такую метрику нельзя без проверки подставить вместо нужного вопроса слушателю. Это локальный отрицательный результат данного протокола, а не доказательство бесполезности UTMOS или NISQA на любых данных.
Источник. Оригинальное название: Human-Likeness and Conversational Preference Diverge for Synthesized Agent Speech in Customer-Service Calls. arXiv:2611.16051; полный текст PDF.