RSE-TTS: восемь векторов речевого образца и общие веса кодирования и синтеза
RSE-TTS сжимает речевой образец в восемь непрерывных векторов, а одну и ту же сеть использует для их извлечения и дальнейшего синтеза. Это уменьшает обучаемую часть без хранения всей акустической истории образца. Особенно интересен опыт с заменой скрытых состояний: авторы проверяют, где именно текст образца влияет на сходство голоса.
Метод. Global-модуль MOSS-TTS-Nano с 12 слоями и шириной 768 сначала получает текст образца, его аудиокоды и восемь обучаемых запросов. Выходы запросов становятся восемью векторами размерности 768. К ним добавляется проекция 192-мерного представления замороженного CAM++; второй проход того же Global-модуля использует эти условия и новый текст. Генерация авторегрессионная: Local порождает 16 индексов внутри очередного кадра, а представление кадра возвращается в Global для следующего шага. Замороженный декодировщик восстанавливает звук 48 кГц при 12,5 кадра/с. Восемь векторов не являются самостоятельным кодеком с известным битрейтом: это условие для синтеза.
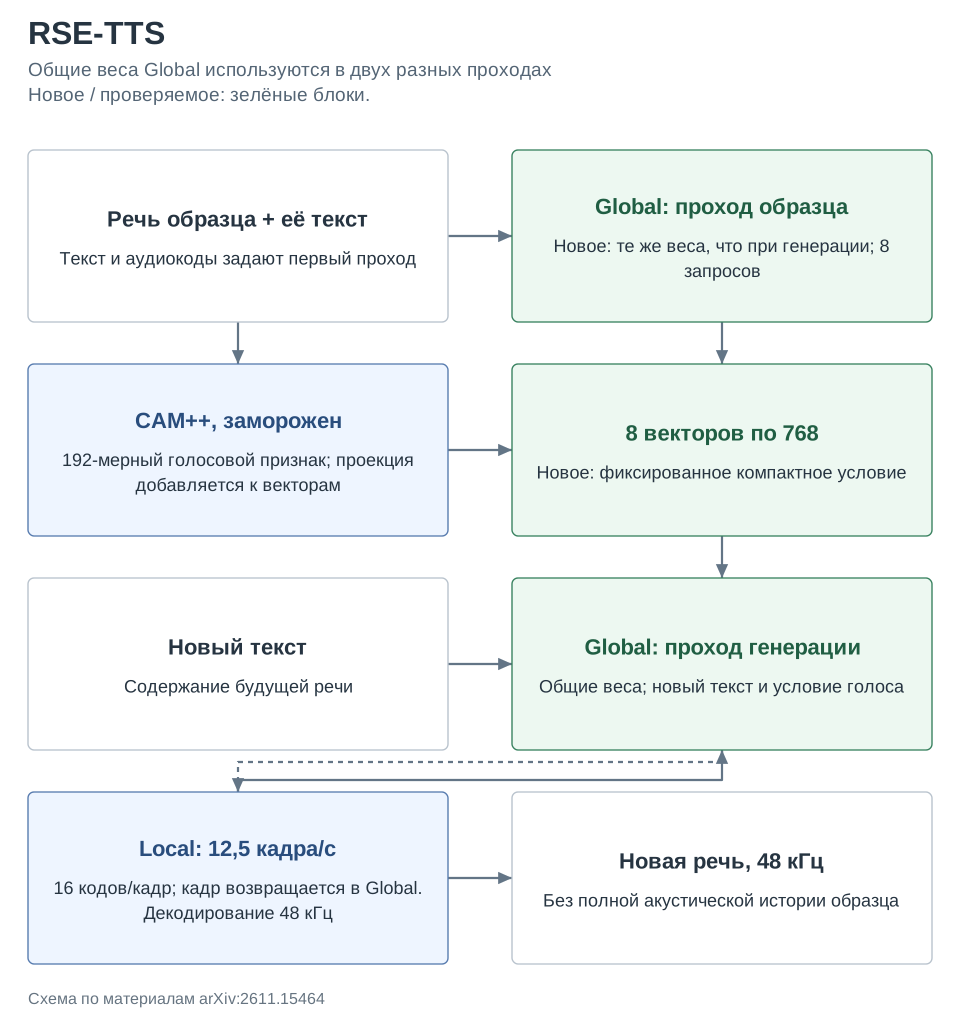
Результаты. В сопоставимом обучении на 20 тыс. часов вариант с раздельными обучаемыми кодировщиками содержит 228,5 млн параметров, а общий RSE-TTS 118,2 млн. На Seed/CV3/MiniMax WER равен 1,33/2,63/0,64%, сходство диктора SIM 0,552/0,499/0,615. Продолжение всей исходной акустической истории сохраняет голос лучше: 0,591/0,526/0,684, но даёт больший WER 1,45/3,48/1,77%. Указанные 129,2 млн активных параметров цепочки генерации включают 11,1 млн декодировщика, но не все модули обработки образца.
Ограничения. Проверка преимущественно англоязычная и требует транскрипции образца; неправильный текст заметно меняет голос. Компактное условие не достигает сходства полноценного продолжения. Сокращение параметров не равнозначно измеренному RTF или задержке, которых для такого вывода недостаточно. Исследование скрытых состояний выполнено в определённых слоях и на ограниченной группе образцов, а не доказывает универсальное разделение текста и личности.
Фишка из статьи. Таблица 3 вмешивается в модель, запущенную с перевёрнутым текстом образца: в отдельные позиции подставляют состояния из запуска с правильным текстом. Без вмешательства SIM равен 0,497; правильный текст даёт 0,538. Эффект перемещается от ранних аудиопозиций к поздним восьми запросам.
| Какие состояния восстановлены | Слой | SIM после замены |
|---|---|---|
| Никакие, текст перевёрнут | Не применяется | 0,497 |
| Аудиопозиции образца | 3 | 0,545 |
| Аудиопозиции образца | 9 | 0,499 |
| Восемь запросов | 3 | 0,503 |
| Восемь запросов | 9 | 0,542 |
Как это читать: полезная информация сначала выражена в промежуточных акустических состояниях, а к поздним слоям собрана в компактных запросах. Поздняя замена аудиосостояний почти ничего не исправляет, тогда как замена запросов восстанавливает сходство. Обратные подстановки портят результат, что усиливает вывод о влиянии этих состояний, а не только о корреляции визуализаций внимания.
Источник. Оригинальное название: RSE-TTS: Compact Text-to-Speech through Shared Text-Aware Reference Encoding and Generation. arXiv:2611.15464; полный текст PDF.