JEV-VAD: определение конца реплики с коротким декодером и скалярным выходом
Определять конец реплики через генерацию слов из большого словаря избыточно, если приложению нужна одна вероятность. JEV-VAD превращает Qwen3-ASR в такой оценщик и проверяет, сколько слоёв декодера действительно необходимо. Работа интересна аккуратным разделением трёх вещей: числа параметров, расчётных операций и качества политики ожидания.
Метод. Входом служат уже услышанные 2,56 секунды речи с обновлением каждые 320 мс. Замороженный акустический кодировщик выдаёт 33 токена; вопрос и критерии завершения стоят перед ними, чтобы причинное внимание аудиотокенов видело инструкцию. Вместо словарной проекции используется скалярная голова из 1 025 параметров. Обучают LoRA и эту голову, всего около 4,59 млн параметров, в стадиях SFT и RLCD. При сокращении декодера голову заново подгоняют для каждой глубины, включая полный вариант: это не перенос неизменной головы с последнего слоя на ранний.
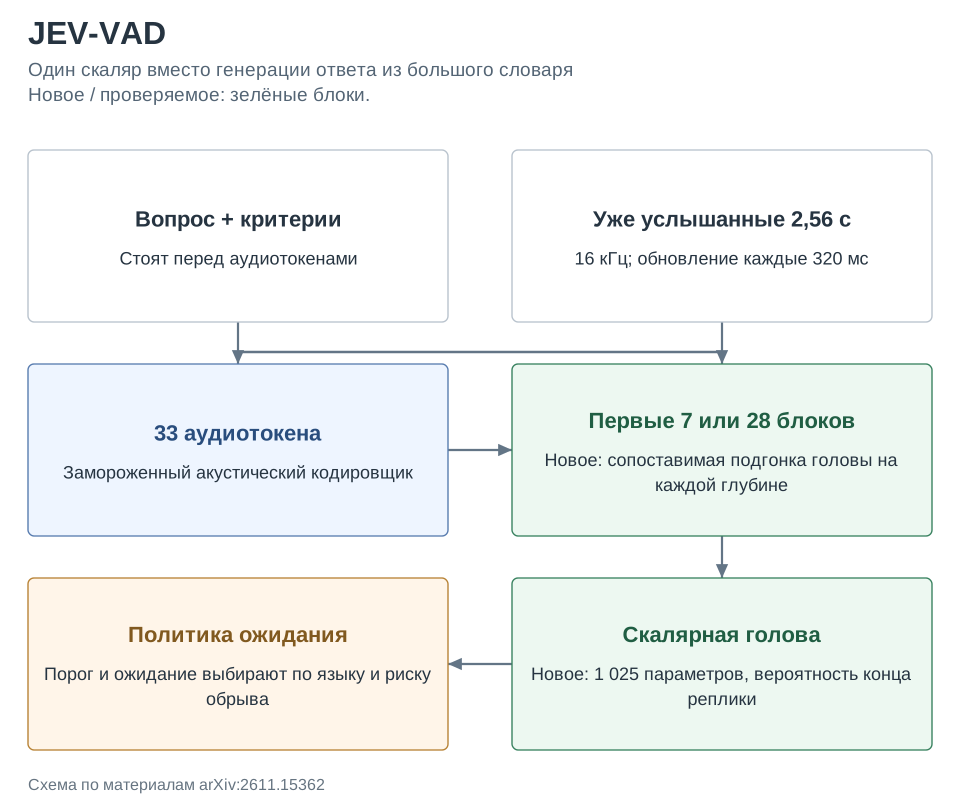
Результаты. Полная модель на 14 языках получает AUC 91,1 и AP 84,2. При выбранной политике доля преждевременных отсечений с бюджетом ожидания 300 мс составляет 19,09%, а ожидание при бюджете 5% отсечений 775,9 мс. LiveKit TD v1 в том же сравнении лучше: 13,99% и 624,5 мс. Сокращение с 28 до 7 блоков уменьшает число развёрнутых параметров с 787,01 до 453,22 млн и расчёт декодерных матричных операций вчетверо, но немного меняет компромисс ошибок и ожидания.
Ограничения. Исследование глубины выполнено для английского и китайского, тогда как 14-языковое сравнение относится к полной модели. Нет отдельного контроля только SFT, позволяющего изолировать вклад RLCD. Операционный подсчёт исключает кодировщик и ряд других вычислений; фактическое ускорение по часам не измерено. Задержки политики не включают время вывода сети. Окно охватывает только прошлое, но внимание внутри уже полученного окна двунаправленное.
Фишка из статьи. Таблицы 4 и 5 показывают цену раннего выхода. Ниже приведён сопоставимый эксперимент с заново обученными головами; английские отсечения и ожидание относятся к разным рабочим точкам политики, а не к одной одновременно достижимой паре.
| Глубина | Все параметры, млн | Декодер, GFLOPs | EN: cut@300ms, % | EN: lat@5%cut, мс |
|---|---|---|---|---|
| 7 блоков | 453,22 | 16,548 | 19,42 | 958 |
| 28 блоков | 787,01 | 66,191 | 17,46 | 869 |
Как это читать: удаление 75% декодерных операций не означает отсутствие потерь: в английском режиме короткая сеть чаще обрывает реплику и дольше ждёт при фиксированном риске обрыва. При этом полная система уменьшается только на 42,41% параметров, поскольку акустическая часть остаётся. Эти числа помогают выбрать глубину под язык и допустимый риск, но не обещают четырёхкратное ускорение приложения.
Источник. Оригинальное название: JEV-VAD: Efficient Semantic Endpointing via Task-First Conditioning and Decoder-Prefix Pruning. arXiv:2611.15362; полный текст PDF.