FineSpeaker: локальные признаки диктора с VAE и генеративным обучением
Представление целой фразы может хорошо узнавать человека, но плохо работать на коротком «да» или границе смены говорящего. FineSpeaker учит локальные признаки диктора через сочетание классификации и генеративного восстановления. VAE здесь служит регуляризацией скрытого представления личности, а не готовым кодеком для передачи звука.
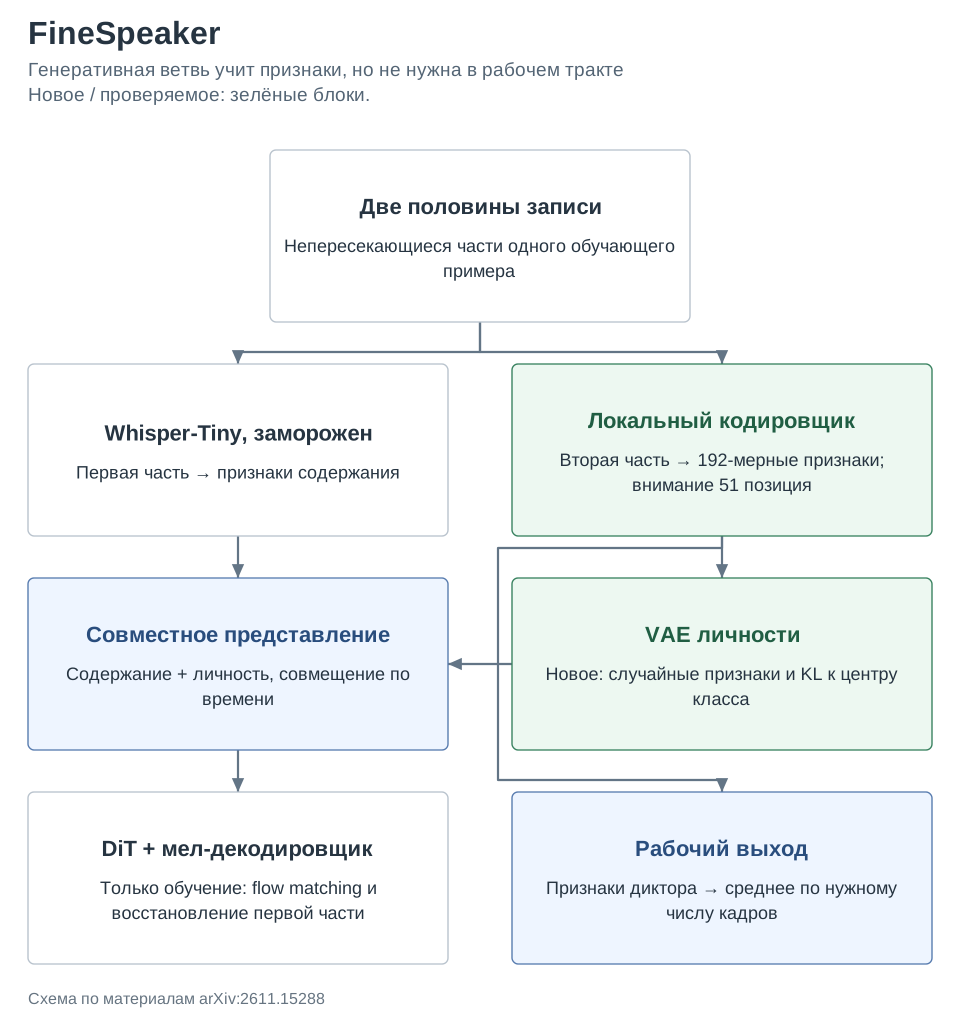
Метод. Четыре ступени многомасштабных свёрток и TCN сохраняют временно́е разрешение после начального уменьшения частоты вдвое. Далее 192-мерные признаки обрабатывает скользящее внимание с окном 51 позиция. При обучении запись делят на две непересекающиеся части: замороженный Whisper-Tiny извлекает содержание первой, речевой кодировщик личность из второй. VAE моделирует распределение признаков диктора с априорным центром его класса; после совмещения по времени признаки объединяют с содержанием, а DiT и мел-декодировщик обучают восстановлению через flow matching. Генеративная ветвь нужна только при обучении; для проверки личности и диаризации извлекают признаки с разным усреднением.
Результаты. На VoxCeleb1-O EER полной модели равен 0,6699% для целой фразы, 3,8427% для одной секунды и 4,7404% при усреднении двух выходных кадров. На VoxConverse DER для двух кадров 10,580%, а на AMI-SDM 22,255%. Английские модели обучаются на VoxCeleb2, китайские на CN-Celeb; диаризация проверяется без специального обучения на целевом корпусе. Два выходных кадра занимают около 40 мс, но модель видит существенно больше контекста через свёртки и симметричное внимание.
Ограничения. Нельзя трактовать шаг признаков как задержку: окно внимания включает будущие позиции, поэтому это не доказанный причинный потоковый метод с задержкой 40 мс. При сравнении кодировщиков необходимо выравнивать реальную длительность, а не только число кадров. Генеративный компонент улучшает не все режимы и не изолирует личность идеально. Для VAE не представлены битрейт, квантованный поток и самостоятельное восстановление звука при применении; называть его компрессором некорректно.
Фишка из статьи. Таблица VI позволяет отделить эффект генеративной ветви от простого обучения на коротких фразах. Удаление генератора почти не портит результат двух кадров, а обучение короткими фразами даже лучше на 0,5 с. Преимущество полной модели становится яснее на более длинном входе.
| Вариант | EER: 0,5 с, % | EER: 2 с, % | EER: 2 кадра, % |
|---|---|---|---|
| Полная модель | 9,1226 | 1,7345 | 4,7404 |
| Без генеративной ветви | 10,4581 | 1,8426 | 4,9340 |
| Обучение короткими фразами | 8,7977 | 2,0367 | 4,7039 |
Как это читать: генеративное обучение даёт компромисс между длительностями, а не универсальный выигрыш в каждой ячейке. Само наличие VAE не объясняет весь большой отрыв от других кодировщиков: существенна локальная архитектура. Формулировка «два кадра» обозначает усреднение выхода, а не отсутствие контекста за пределами этих 40 мс.
Источник. Оригинальное название: FineSpeaker: Reliable Speaker Representation Learning at Fine Temporal Resolution. arXiv:2611.15288; полный текст PDF.