ROSETok: устойчивость речевых токенизаторов и разрыв между качеством звука и смыслом
Хорошо восстановленная речь ещё не означает, что её представление сохраняет правильный смысл. Авторы исследуют переносимые возмущения речевых токенизаторов и обучают ROSETok одновременно восстанавливать чистый сигнал и согласовывать признаки с семантическим учителем. Самый полезный результат работы: почти одинаковые PESQ и STOI могут скрывать совершенно разное качество последующего понимания речи.
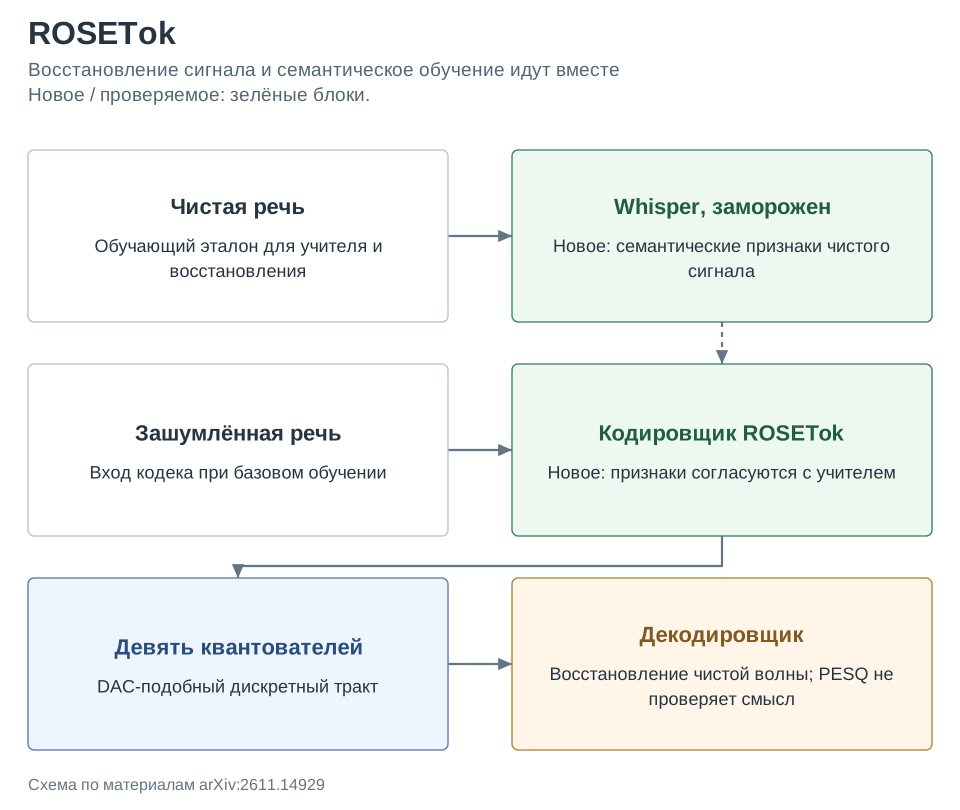
Метод. ROSETok использует кодировщик, девятислойный квантователь и декодировщик на основе DAC. В основной стадии зашумлённая запись должна восстанавливать чистую речь, а представление кодировщика приближается к признакам замороженного Whisper, полученным из чистого сигнала. Базовую модель обучают на 96,7 тыс. часов английской и китайской речи Emilia; затем вариант AAF дополнительно адаптируют к возмущениям на 2 000 фразах LibriSpeech. Работа отдельно проверяет представления до квантования: это важно, поскольку результаты непрерывного входа аудиомодели нельзя автоматически переносить на любой дискретный поток кодов.
Результаты. В таблице 4 у ROSETok-Base STOI составляет 0,966 на чистом сигнале, 0,950 при гауссовом шуме и 0,842 при исследуемом возмущении. Доля правильных ответов на FSC с последующей моделью SmolLM2 равна 93,0%, 92,9% и 62,4%. После AAF последний показатель повышается до 77,9%, но чистый STOI снижается до 0,945: защита имеет цену. Для базового варианта указан RTF 0,010; для AAF в этой строке измерения нет, поэтому приписывать ему ту же скорость нельзя.
Ограничения. Проверены конкретные семейства возмущений и преимущественно два языка, а не произвольная эксплуатационная среда. Девять квантователей сами по себе не задают известный битрейт: для рассматриваемой конфигурации нельзя восстановить его без частоты кадров и размеров кодовых книг. Метрики восстановления, семантические задачи и разные диагностические классификаторы оценивают разные свойства. Работа не даёт универсальной гарантии устойчивости и не устанавливает задержку полного диалогового приложения.
Фишка из статьи. В таблице 6 меняют только семантического учителя ROSETok-Base: Whisper заменяют на HuBERT. Качество восстановления практически не меняется, однако точность отдельного диагностического MLP на FSC падает более чем вдвое. Это проверка состава представления, а не очередное сравнение средних показателей звука.
| Учитель | STOI: чистый / шум | PESQ: чистый / шум | FSC, MLP, % |
|---|---|---|---|
| Whisper | 0,965 / 0,950 | 3,063 / 2,431 | 73,90 |
| HuBERT | 0,965 / 0,950 | 3,088 / 2,453 | 31,48 |
Как это читать: вторая модель даже чуть лучше по PESQ, но заметно хуже передаёт сведения, нужные классификатору команд. Выбирать токенизатор только по реконструкции опасно. Числа FSC здесь относятся к MLP из таблицы 6, а не к SmolLM2 из основного сравнения: смешивать эти два протокола нельзя.
Источник. Оригинальное название: Speech Tokenizers are Vulnerable: Transferable Semantic Attack and Robust Tokenizer. arXiv:2611.14929; полный текст PDF.