Hy ASR 3.0: контекстное распознавание речи и неоднозначность оценки диалектов
Hy ASR 3.0 объединяет акустические признаки с большой языковой моделью и внешним контекстом. Интересна не только точность на китайской и английской речи, но и явное различение контекста внутри фразы, контекста диалога и правил записи диалектов. В последнем случае «правильно по смыслу» и «полностью правильная транскрипция» дают разные сравнения систем.
Метод. Аудиокодировщик предварительно обучают итеративно: BEST-RQ создаёт начальные представления, HuBERT уточняет их, а остаточное векторное квантование задаёт многоуровневые цели следующей стадии. Кодировщик и адаптер подают аудиопредставления в декодер на базе Hy3; эти же акустические признаки участвуют в отборе специальных слов из внешнего списка. Найденные слова, резюме и пары вопрос–ответ кодируются как текстовый префикс перед аудио. Большое обучение на десятках миллионов часов дополняют перебалансировкой диалектов, смешением речевых фрагментов и последующими стадиями адаптации. RVQ в этом месте служит целям самообучения, а не опубликованному аудиокодеку.
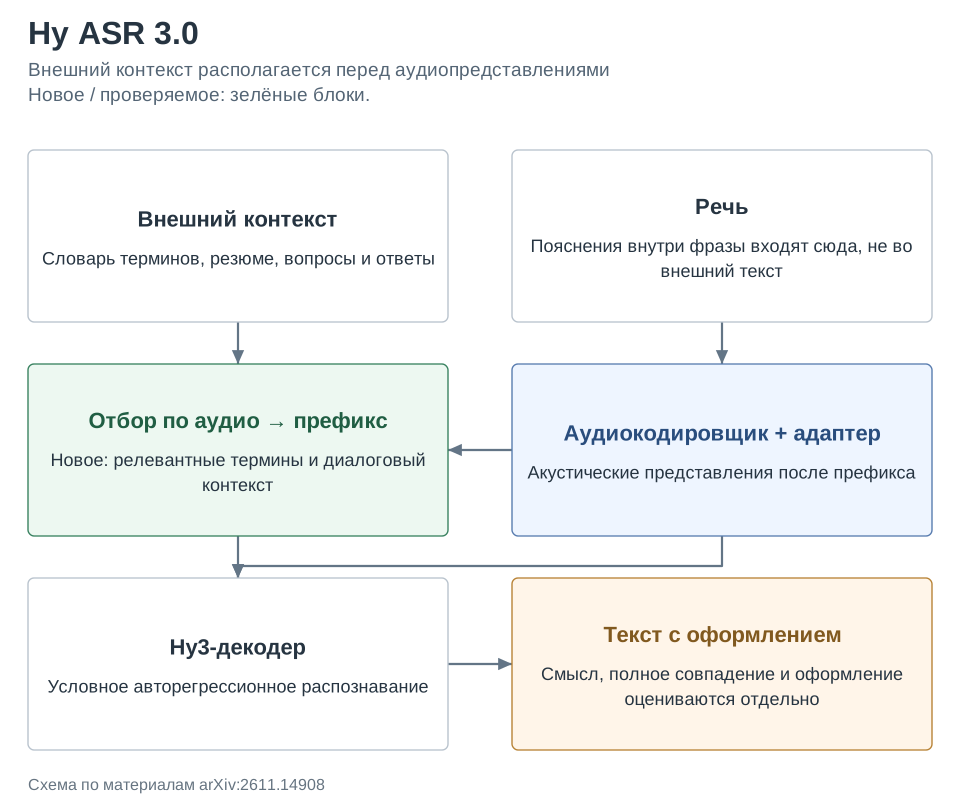
Результаты. Во внутренних тестах CER составляет 2,35% для длинных записей, 6,25% для объединённой группы детской и пожилой речи и 7,49% для объединённой группы тихой и шумной речи. В контекстном тесте полнота нужных единиц равна 61,88% для подсказок внутри фразы и 83,94% для диалогового контекста. Экспертная оценка охватывает 13 категорий диалектов и 91 региональную разновидность. Доля полностью правильных расшифровок 64,7%, а доля текстов без проблем оформления 80,3%; это не CER и не WER.
Ограничения. Многие результаты относятся к внутренним наборам и авторскому протоколу. Примеры разрешения омонимии качественные, а не контрольное отключение конкретного механизма контекста. Объединённый тест возрастов не доказывает отдельного выигрыша для каждой группы. Для диалектов без устойчивой письменной нормы используется переводоподобная запись; разные критерии закономерно расходятся. Нет оснований выводить из отчёта измеренную потоковую задержку или независимость от больших закрытых обучающих ресурсов.
Фишка из статьи. Раздел о диалектах показывает, как меняется вывод при смене критерия. Преимущество в полном совпадении и оформлении не означает лучшего сохранения смысла. Разности ниже взяты из итоговой экспертной оценки на тех же категориях, а не пересчитаны из CER.
| Критерий | Hy ASR 3.0 относительно FunASR Flash | Относительно Doubao ASR 2.0 |
|---|---|---|
| Полностью правильное содержание | +2,8 п.п. | +12,5 п.п. |
| Правильный смысл с допустимыми вариантами | -1,0 п.п. | Выше, точная разность в тексте не дана |
| Правильное оформление текста | +11,4 п.п. | +13,7 п.п. |
Как это читать: оценка «лучший распознаватель диалектов» зависит от назначения результата. Для передачи смысла FunASR остаётся немного сильнее по мягкому критерию; для готового правильно оформленного текста Hy выигрывает. На группе Wu конкурент также сильнее по всем трём критериям. Поэтому агрегат не отменяет региональных и редакционных ограничений.
Источник. Оригинальное название: Hy ASR 3.0 Technical Report. arXiv:2611.14908; полный текст PDF.