DRO-BEST-RQ: адаптивные веса кодовых книг при самообучении речи
Случайные кодовые книги BEST-RQ задают несколько разных задач предсказания скрытых речевых кадров. Обычно их ошибки просто усредняют. DRO-BEST-RQ увеличивает вес более трудных книг, но ограничивает концентрацию весов: эксперимент показывает, что обучение только по самой трудной задаче оказывается хуже мягкого перераспределения.
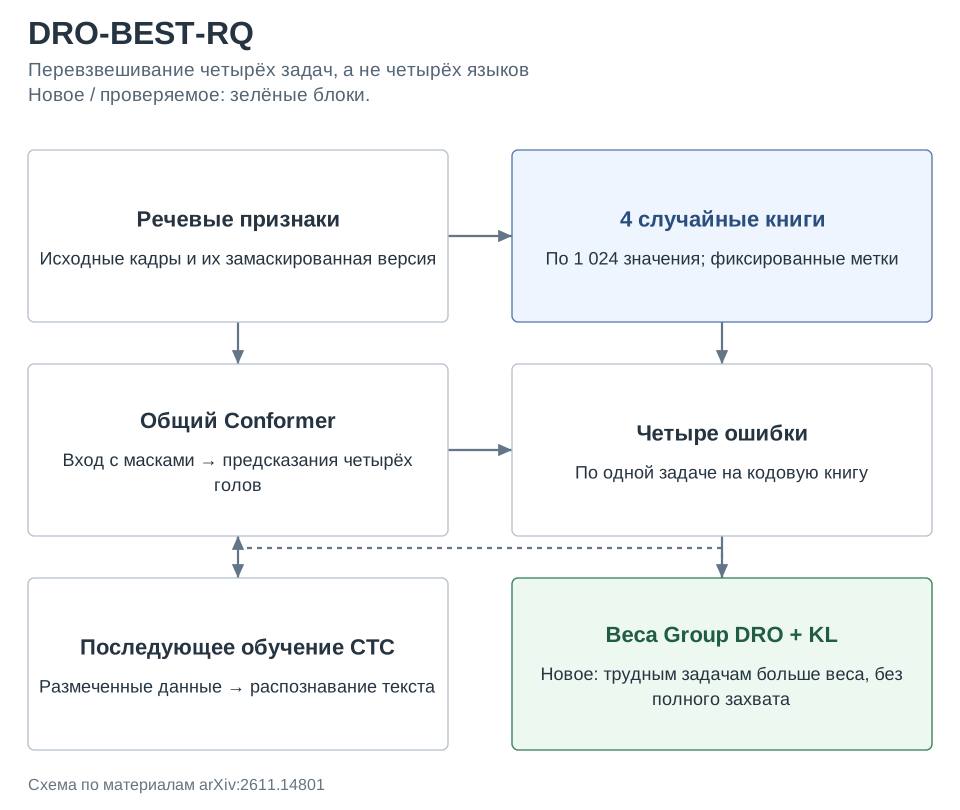
Метод. Четыре фиксированных случайных квантователя по 1 024 элемента формируют метки. Общий Conformer предсказывает их для замаскированных входных кадров через четыре выходные головы. Group DRO здесь группирует потери по кодовым книгам, а не по языкам или дикторам. KL-регуляризация к равномерному распределению не позволяет всем весам сосредоточиться на одной книге. После самообучения выход заменяют на CTC и дообучают распознаватель. Частота представления 12,5 кадра в секунду не является битрейтом самостоятельного кодека: задача здесь не сжатие с восстановлением аудио.
Результаты. На пяти языках MLS средний WER снижается с 10,4% у модели без самообучения до 9,3% с одной книгой, 8,9% с четырьмя равновесными книгами и 8,4% при DRO с коэффициентом KL, равным 1,0. На португальском, где обучающих данных меньше всего, результат меняется с 18,9 до 17,7%. Предварительное и последующее обучение используют 8 121,73 часа; второе уже требует транскрипций всего этого объёма. Каждая стадия длится 30 эпох на восьми H100, при оценке применяется жадное декодирование.
Ограничения. Проверены пять языков чтения MLS, без независимого подтверждения на шумной и спонтанной речи. Улучшение малоресурсного языка относительно остальных не означает обучение с малым общим бюджетом размеченных данных. Разброс по нескольким случайным инициализациям и доверительные интервалы итоговых WER не приведены. Иллюстративные веса книг из одной итерации не описывают средние веса всего обучения.
Фишка из статьи. Таблица 3 содержит важный отрицательный контроль: предельный вариант без KL, который целиком выбирает самую трудную книгу, уступает простому равномерному усреднению. Полезен не сам ярлык «робастная оптимизация», а ограничение её чрезмерной избирательности.
| Смешивание четырёх задач | Средний WER, % | Португальский WER, % |
|---|---|---|
| Равномерные веса | 8,9 | 18,9 |
| DRO, KL = 0 | 9,1 | 20,0 |
| DRO, KL = 0,5 | 8,6 | 18,5 |
| DRO, KL = 1,0 | 8,4 | 17,7 |
| DRO, KL = 1,5 | 8,6 | 18,4 |
Как это читать: слишком жёсткая фокусировка теряет пользу нескольких представлений, а слишком сильное сглаживание снова ослабляет адаптацию. Лучшее значение находится между этими крайностями. Это проверка конкретного диапазона коэффициентов, а не гарантия, что 1,0 оптимально для любого корпуса или числа кодовых книг.
Источник. Оригинальное название: Distributionally Robust BEST-RQ For Speech Representation Learning. arXiv:2611.14801; полный текст PDF.