Полнодуплексный голосовой диалог с замороженной языковой моделью и явным управлением временем
Голосовой агент должен решать не только что сказать, но и когда молчать, продолжать или уступить слово. Авторы добавляют такое управление к уже обученной аудиоязыковой модели, сохраняя её основные веса. Ключевой ход состоит в общем временном такте и небольшом обучаемом интерфейсе, а не в повторном обучении всей системы с нуля.
Метод. Замороженный thinker Qwen3-Omni получает аудиокоды Mimi и через адаптеры и новые временные представления выдаёт текстовые либо управляющие токены с шагом 80 мс, то есть 12,5 Гц. Конечный автомат ограничивает допустимые состояния начала, окончания и пауз. Отдельный talker преобразует дискретный текст и собственную историю аудиокодов в речь; в проверяемой конфигурации его пользовательский аудиоканал обнулён. Текст опережает звук на три кадра, 240 мс. Обучаемая часть thinker содержит около 97 млн параметров. Учебная программа постепенно добавляет паузы, многорепличность, перебивания и короткие подтверждения слушателя.
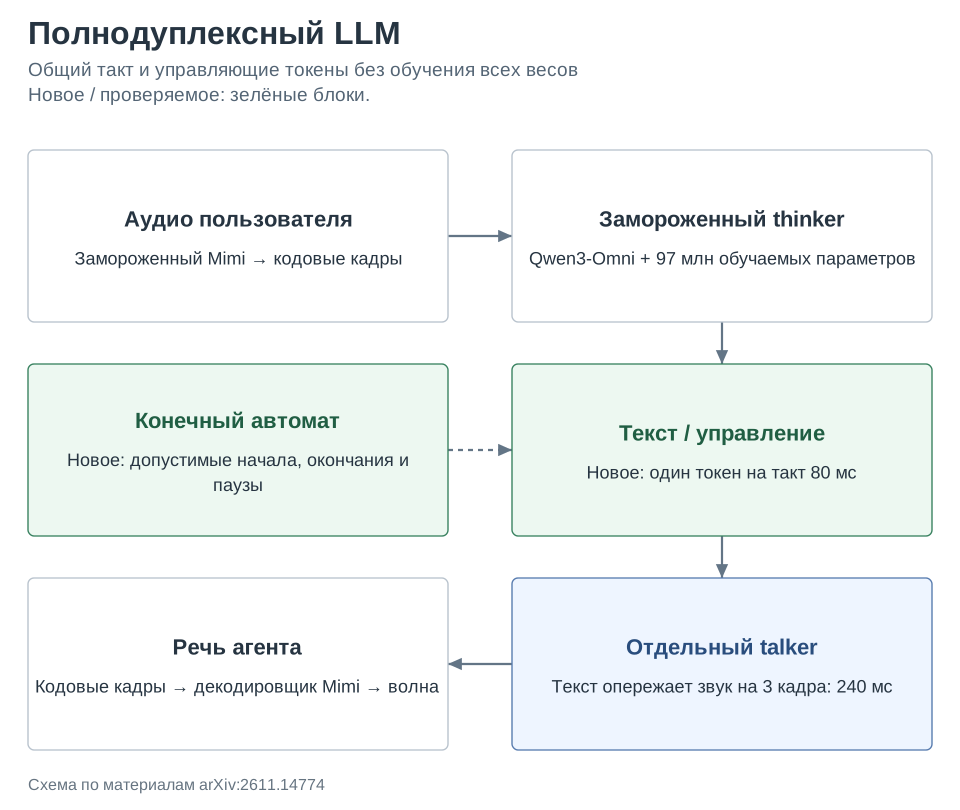
Результаты. На Full-Duplex-Bench v1 частота захвата слова во время пользовательской паузы равна 0,170 на синтетической части и 0,267 на Candor против 0,584 и 0,662 у PersonaPlex; здесь меньше лучше. Однако обычная смена реплик медленнее: 0,44 с против 0,070 с у PersonaPlex, а оценка уместности после перебивания 2,681 против 4,210 по шкале 0–5. Это улучшение конкретного поведения, не превосходство по всем свойствам разговора. Конвертация thinker занимает 30,5 GPU-часа B200, но эта сумма не включает предварительное обучение исходных моделей и подготовку данных.
Ограничения. 80 мс задают проектный бюджет одного шага, а не измеренную сквозную задержку приложения. Компактная адаптация наследует стоимость и возможности крупных заранее обученных thinker, talker и кодека. Часть тестов мала или синтетическая; качество зависит от фонового звука. Текущий интерфейс talker не получает пользовательскую просодию, поэтому его нельзя описывать как полностью акустически обусловленное подражание собеседнику.
Фишка из статьи. Таблица 1 раскладывает расходы преобразования thinker по стадиям. Основное время уходит не на произнесение текста, а на взаимодействие: перебивания и подтверждения слушателя вместе занимают 22,1 из 30,5 GPU-часа. Это позволяет увидеть, что именно стоит за небольшой общей стоимостью адаптации.
| Группа стадий | B200 GPU-часы | Что осваивается |
|---|---|---|
| Чтение кодов + дистилляция | 3,1 | Базовый выход речи и привязка к исходной модели |
| Паузы + два канала + многорепличность | 5,3 | Распределение речи во времени |
| Перебивания | 9,1 | Уступка и возврат слова |
| Подтверждения слушателя | 13,0 | Короткие реакции без захвата реплики |
Как это читать: это стоимость конкретной конвертации готового thinker, а не создания голосовой модели с нуля. Суммы сгруппированы из отдельных строк авторов. Сравнивать их с полным бюджетом обучения другой системы некорректно; зато они показывают, что временное поведение требует отдельной, содержательно организованной стадии обучения.
Источник. Оригинальное название: An LLM Is All You Need: Data-Efficient Adaptation to Full-Duplex, Word-Level Spoken Dialogue. arXiv:2611.14774; полный текст PDF.