ESDCodec: речевой кодек на 0,85 кбит/с с семантическим квантованием и подполосным декодером
ESDCodec сжимает речь до номинальных 850 бит/с, разделяя языковое содержание и акустические подробности. Интересен не только низкий поток данных: подполосная подсказка декодеру улучшает одновременно восстановление голоса и сохранность произносимых слов.
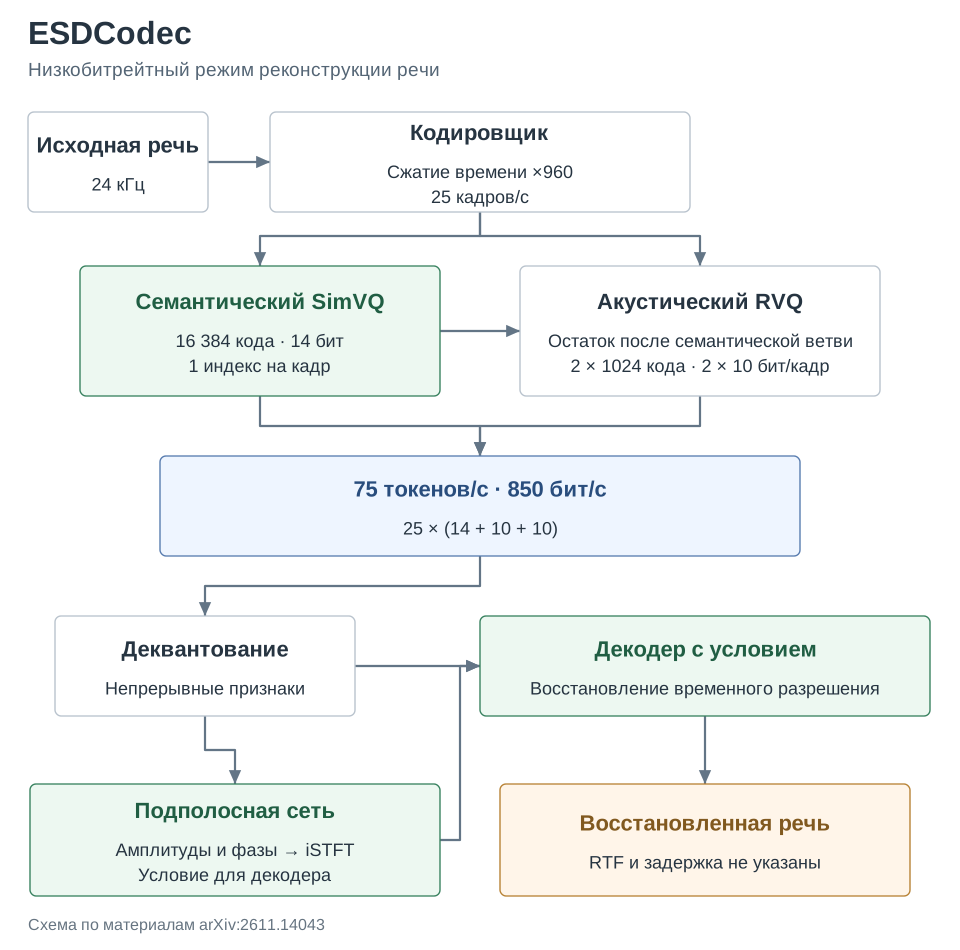
Метод. Сигнал 24 кГц преобразуется в 25 кадров/с. Один семантический словарь на 16 384 элемента и два акустических словаря на 1024 элемента дают 75 токенов/с: 25 × (14 + 10 + 10) = 850 бит/с без служебных расходов. Семантический SimVQ использует фиксированную случайную матрицу с обучаемым линейным преобразованием, а признаки w2v-BERT 2.0 служат учителем. Дополнительная сеть предсказывает подполосные амплитуды и фазы, восстанавливает сигнал через iSTFT и передаёт подсказки основному декодеру. Это именно кодек реконструкции речи, а не только скрытое представление для генерации.
Результаты. На 2620 записях LibriSpeech test-clean получены PESQ 2,49, STOI 0,921, ViSQOL 2,74 и WER 4,18%. У сопоставимого DualCodec при тех же 850 бит/с и 75 токенах/с: 2,32; 0,912; 2,61 и 4,70%. MUSHRA составляет 88,2 против 85,8. Полная модель содержит 89,78 млн параметров; подполосная часть добавляет около 9,6 млн. Обучение использует 97 тыс. часов английской и китайской речи.
Ограничения. Субъективная проверка мала: 10 слушателей и 15 фраз. Не приведены RTF, алгоритмическая задержка и память, поэтому низкий битрейт не доказывает пригодность для потоковой связи. Эксперимент синтеза использует восемь кодовых книг и не является проверкой режима 850 бит/с. XCodec при более высоком потоке 1 кбит/с имеет меньший WER 3,75%.
Фишка из статьи. В таблице 3 на с. 4 отключение подполосного условия едва меняет PESQ, но заметно повреждает содержание. Замена семантического квантователя обычным VQ действует существенно слабее. Таким образом, по одной перцептивной метрике важность этого компонента легко недооценить.
| Конфигурация | PESQ | STOI | WER, % |
|---|---|---|---|
| Полная | 2,49 | 0,921 | 4,18 |
| Обычный семантический VQ | 2,43 | 0,919 | 4,43 |
| Без подполосного условия | 2,42 | 0,916 | 6,38 |
Как это читать: Без условия WER растёт на 2,20 процентного пункта при падении PESQ всего на 0,07. Подсказка нужна не только для тембра и фазовой точности: она помогает сохранить разборчивое языковое содержание при жёстком ограничении потока.
Источник. Оригинальное название: ESDCodec: Ultra-Low Bitrate Speech Codec with Enhanced Semantic Disentanglement and Subband Decoding. arXiv:2611.14043; полный текст PDF.