Акустическое восстановление набранного текста: перенос между клавиатурами и языковая коррекция
Звук нажатой клавиши зависит не только от самой клавиши, но и от корпуса клавиатуры, микрофона и помещения. В этой магистерской диссертации Decker учится распознавать нажатия на незнакомых клавиатурах, подавляя сведения об устройстве в акустическом представлении; языковая модель затем исправляет часть ошибок последовательности. Работа интересна как исследование переноса акустических признаков и риска утечки через звук, но её результаты нельзя читать как гарантию восстановления произвольного текста из любой записи.
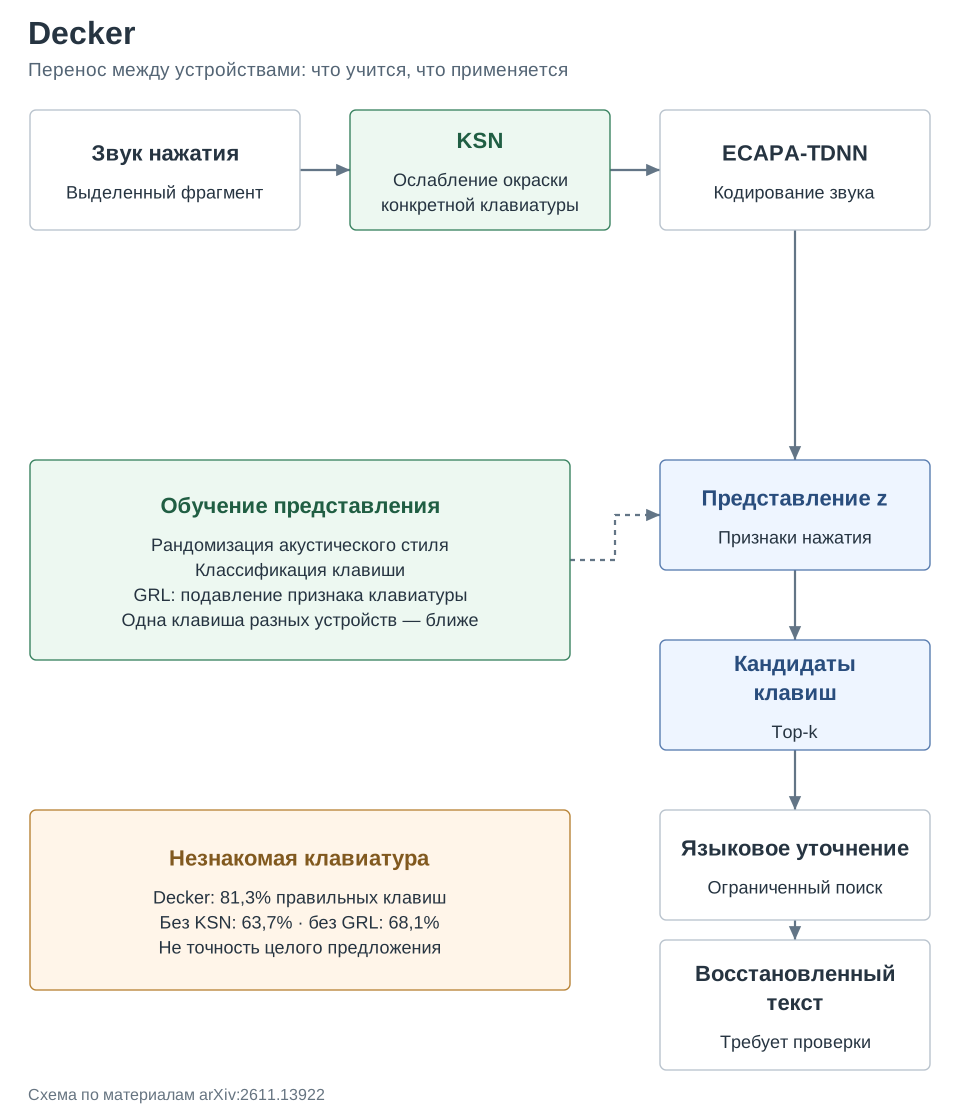
Метод. Модуль Keyboard Signature Normalization (KSN) должен ослабить характерную для устройства спектральную окраску до кодировщика ECAPA-TDNN. При обучении Acoustic Style Randomization меняет акустический стиль, а три цели формируют представление: классификация клавиши, состязательное подавление признака клавиатуры через обращение градиента GRL и сближение записей одной клавиши с разных устройств. В этой статье ASR обозначает именно рандомизацию стиля, а не распознавание речи. При применении список наиболее вероятных клавиш поступает в ограниченный языковой поиск; он уточняет последовательность, не заменяя акустическую модель свободным сочинением текста.
Протокол. Корпус HEAR собран у 53 участников на 37 ноутбучных клавиатурах; он включает внешние и встроенные микрофоны, переданный по VoIP звук и несколько уровней фонового шума. Основной тест отделяет незнакомые клавиатуры от обучающих, а не перемешивает события одной клавиатуры между частями данных. Есть дополнительные проверки по людям и условиям записи. Для клавиш используются размеченные события; автор отдельно вносит ошибки временных границ, чтобы оценить чувствительность к сегментации. Поэтому основное сравнение ещё не равнозначно полностью пассивному распознаванию непрерывного неизвестного аудио.
Результаты. В таблицах 8.1–8.3 ECAPA-TDNN без специальной защиты от смены устройства имеет 95,3% точности на знакомых и 58,1% на незнакомых клавиатурах; полная Decker — 98,9% и 81,3%. Лучшее объединение волновых и спектрограммных признаков достигает на незнакомых устройствах 66,2%: простое добавление второй ветви не убирает аппаратную зависимость. При языковой коррекции FLAN-T5 Base доля полностью восстановленных предложений повышается с 42,6% до 62,1%, а в варианте с GPT-4 — до 72,8% (таблица 8.4). Это точное совпадение целого предложения, его нельзя смешивать с 81,3% правильных отдельных клавиш.
Ограничения. Исследование использует контролируемый набор текстов и размеченные события, хотя устройства и условия разнообразны. Проверка с временным сдвигом границ до ±20 мс снижает точность клавиши с 81,3% до 75,4%, а точное восстановление предложения с FLAN-T5 — с 62,1% до 58,1%. Для случайных строк языковой модели почти нечего восстанавливать по языковым закономерностям: заявленный прирост точного совпадения для высокоэнтропийных строк не превышает примерно 2–3 п.п. Данные доступны для академического исследования по запросу, а не как безусловно открытая загрузка. Это диссертация с авторскими экспериментами на одном корпусе; независимой воспроизводимости и универсальности чисел она не устанавливает.
Фишка из статьи. Нормализация KSN меняет два разных диагностических результата в противоположные стороны: правильную клавишу на новом устройстве определить легче, а конкретную клавиатуру по представлению — труднее. В таблице 8.3 и разделе 8.4.1 это проверяется отдельно. Такой контроль важен: увеличение точности само по себе не показывает, перестала ли сеть узнавать устройство вместо нужного события.
| Диагностика | Без KSN, % | Полная Decker, % | Смысл изменения |
|---|---|---|---|
| Клавиша на знакомой клавиатуре | 96,9 | 98,9 | Прирост 2,0 п.п. |
| Клавиша на незнакомой клавиатуре | 63,7 | 81,3 | Прирост 17,6 п.п. |
| Определение клавиатуры отдельным классификатором | 94,2 | 21,7 | Меньше сведений об устройстве |
Как это читать: основная польза KSN проявляется именно при смене аппаратуры: прибавка там существенно больше, чем на знакомой клавиатуре. Последняя строка — отдельный диагностический классификатор, а не ошибка распознавания клавиш; для неё снижение желательно. Однако 21,7% нельзя автоматически объявить случайным уровнем или доказательством полной независимости представления от устройства. Сами результаты остаются проверкой конкретного корпуса, а не обещанием универсальной защиты от смены акустических условий.
Источник. Оригинальное название: Domain-Invariant and Language-Model-Assisted Acoustic Side-Channel Attacks on Keyboards. arXiv:2611.13922; полный текст PDF.