Emilia2: крупный корпус для управляемого синтеза длинной речи и диалогов
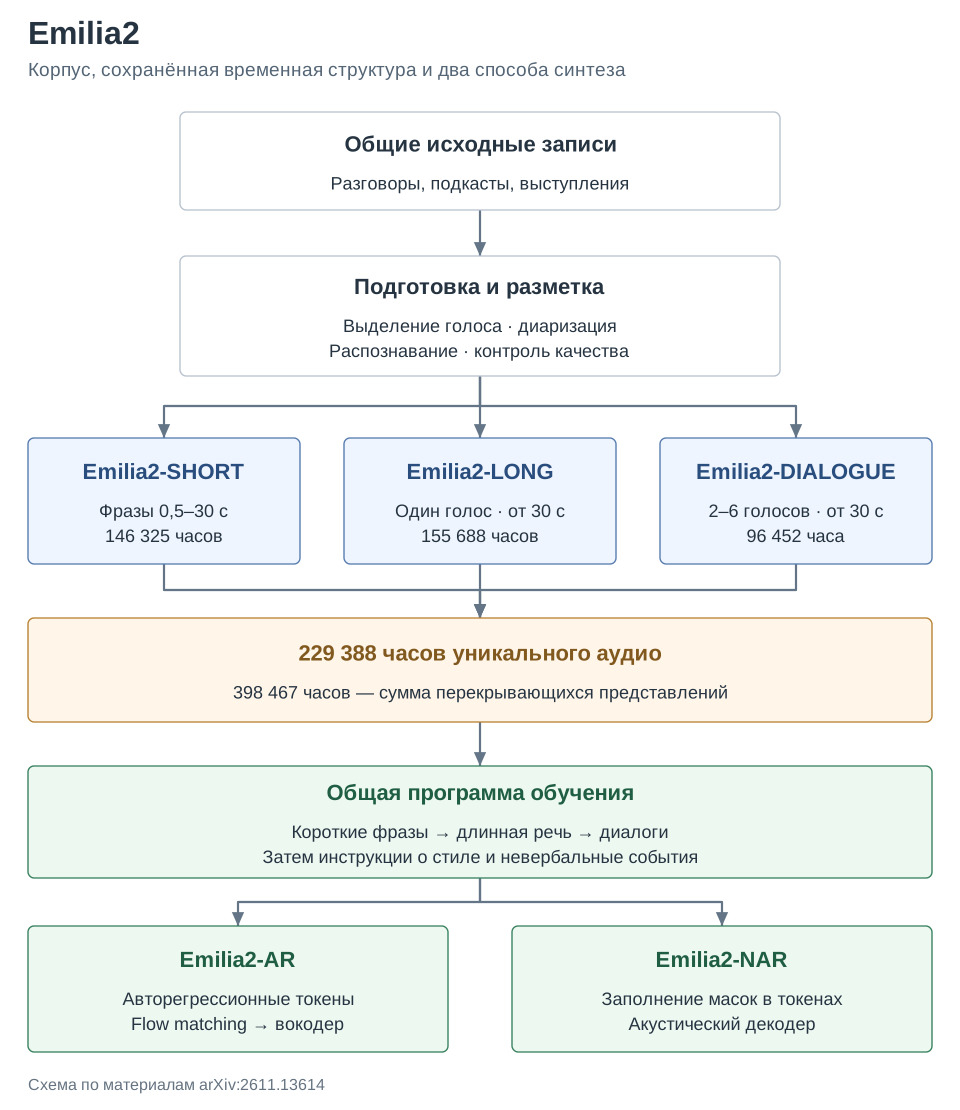
Emilia2 переносит подготовку данных для синтеза с отдельных фраз на непрерывные записи и многоголосые диалоги. Главный вклад состоит в сохранении исходных пауз, переходов и смен говорящих, а также в проверке того, какие ошибки короткие тесты скрывают на записях до получаса.
Метод. Конвейер выделяет голос, выполняет диаризацию, распознавание и контроль качества, затем строит короткие, длинные одноголосые и диалоговые представления одних источников. После устранения перекрывающегося аудио остаются 229 388 уникальных часов на 41 языке; сумма трёх представлений 398 467 часов не означает столько независимых данных. Инструкции о манере речи охватывают 25 053 часа, невербальные события размечены для английского и китайского. Две модели на Qwen3-0.6B проверяют разные способы генерации: авторегрессионные токены с flow matching и параллельное заполнение масок в акустических токенах.
Результаты. Новый тест содержит 118 записей, 23,3 часа, до четырёх голосов и среднюю длительность 11,85 минуты. На нём Emilia2-AR получает китайский CER 3,67% и английский WER 6,82%; Emilia2-NAR: 8,62% и 6,62%. На TTSD-Eval параллельная модель даёт CER 5,27% и WER 9,93%, тогда как MOSS-TTSD на 8 млрд параметров получает 6,08% и 11,09%. Это не универсальное превосходство: на новом длинном тесте MOSS-TTSD сильнее по большинству показателей.
Ограничения. Большая часть разметки автоматическая; полная языковая широта корпуса не подтверждена столь же широкой субъективной оценкой. Основной длинный тест двуязычный. Публичный выпуск описан через манифесты источников и производные материалы, а не как безусловное право перераспространять всё исходное аудио.
Фишка из статьи. Таблица 20 на с. 26 показывает конфликт точности текста и цельности звучания. Генерация независимых коротких кусков помогает распознавателю, но слушатели оценивают непрерывный синтез выше. Для NAR используются одинаковые 256 шагов в обоих режимах.
| Модель, китайский тест | Режим | CER, % | N-MOS |
|---|---|---|---|
| Emilia2-AR | Кусками | 4,36 | 3,30 |
| Emilia2-AR | Целиком | 3,67 | 4,05 |
| Emilia2-NAR | Кусками | 1,73 | 3,90 |
| Emilia2-NAR | Целиком | 8,62 | 4,05 |
Как это читать: Снижение CER с 8,62 до 1,73% не делает речь естественнее: N-MOS падает с 4,05 до 3,90. Проверка естественности здесь использует лишь пять китайских и пять английских случаев, поэтому важен сам выявленный компромисс, а не точность малой разницы MOS.
Источник. Оригинальное название: Emilia2: A Large-Scale Dataset for Controllable Long-Form Speech Generation. arXiv:2611.13614; полный текст PDF.