Непальско-английское распознавание речи: подготовка данных и адаптация SraVaani
При распознавании речи со сменой языка модель должна не только узнать слово, но и записать его нужным алфавитом. Авторы адаптируют SraVaani к непальско-английским разговорам, не меняя словарь и выходные слои: цифры и неподдерживаемые знаки превращаются в варианты произнесения, а подходящую метку помогает выбрать исходная модель. Интерес здесь не в новой архитектуре, а в проверке того, как подготовка разметки, обучение кодировщика и правила оценки меняют результат.
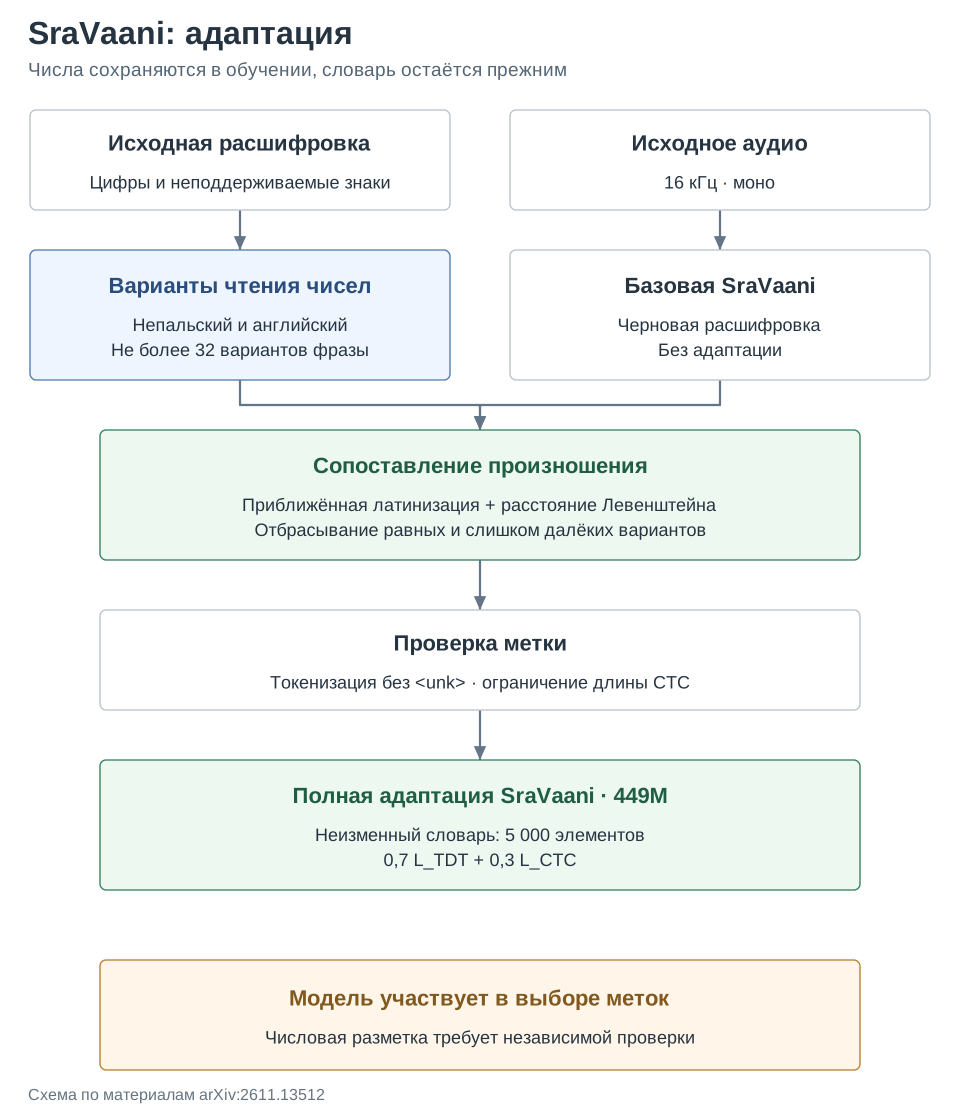
Метод. SraVaani — гибрид FastConformer с декодерами TDT и CTC, около 449 млн параметров и словарём SentencePiece из 5 000 элементов. Для каждого числового выражения строят непальские и английские чтения, оставляя не более 32 полных вариантов фразы. Гипотезу исходной модели и варианты приводят к приближённому произносительному представлению латиницей и сравнивают расстоянием Левенштейна; неоднозначные и слишком далёкие случаи отбрасывают. Затем проверяют обратимость токенизации без неизвестных символов и допустимую для CTC длину метки. В основной конфигурации обучают всю сеть с весами потерь 0,7 для TDT и 0,3 для CTC; скорость обучения кодировщика вдвое ниже, чем у декодеров.
Данные и вычисления. Корпус содержит 172,8 часа из шести областей: чтение, технические лекции, подкасты, новости и беседы, разговоры и интервью. Из них 152,91 часа относятся к обучению, 10,77 — к проверке при обучении и 9,08 — к итоговому тесту из 4 610 фрагментов. Основной шестипроходный запуск занимает около трёх часов на одной RTX 5090; авторы указывают пиковое потребление памяти 19,1 GiB. Это расходы обучения, а не оценка скорости потокового распознавания.
Результаты. На собственном тесте WER снижается с 48,6% без адаптации до 17,1% после шести эпох и до 16,3% после двенадцати; для основного запуска 95%-й интервал составляет 16,6–17,6%. Замороженный кодировщик даёт 25,5%, то есть хуже на 8,4 процентного пункта. Удаление числовых обучающих примеров повышает общий WER до 19,8%, а на 1 125 числовых тестовых фрагментах — с 14,3% до 21,3%. Whisper large-v3-turbo после трёх эпох получает 16,4%; разница с 16,3% у SraVaani статистически незначима по использованной авторами проверке. Поэтому работа показывает сопоставимое качество при меньшей модели, а не доказанное превосходство над Whisper.
Ограничения. Наследованные части корпуса не гарантируют разделения по дикторам: внутридоменная оценка может быть оптимистичной. Выбор числовых меток по выходу самой модели способен закреплять её ошибки; при ранней ручной проверке нашли пять ошибок в 150 числовых фрагментах, после чего правила исправили, но окончательная разметка всё ещё требует независимого прослушивания. Переоформленные эталоны FLEURS также не прошли полную ручную проверку. FLEURS здесь представляет чтение, а не спонтанное смешение языков; Whisper обучался меньше эпох и ещё улучшался. Доверительные интервалы по фрагментам не учитывают зависимость записей одного диктора и разброс между многими запусками.
Фишка из статьи. Одна и та же дообученная модель выглядит лучше или хуже на одних и тех же 586 записях FLEURS в зависимости от того, как записать английские заимствования. В таблице 12 исходные эталоны часто используют деванагари, а альтернативные — латиницу. Смена эталона переворачивает направление изменения WER, но более независимая от письма посимвольная оценка всё равно обнаруживает реальную потерю переноса. Это полезнее простого сообщения об улучшении среднего WER.
| Оценка на неизменном аудио FLEURS | Без адаптации, % | После 6 эпох, % | Что меняется |
|---|---|---|---|
| WER по исходным эталонам | 22,6 | 31,1 | Ухудшение на 8,5 п.п. |
| WER по смешанным алфавитам | 30,0 | 23,4 | Улучшение на 6,6 п.п. |
| CER после латинизации, без пробелов | 5,1 | 7,6 | Ухудшение на 2,5 п.п. |
Как это читать: первые две строки оценивают не разные аудиозаписи, а разные соглашения о правильном тексте. Нельзя выбрать удобную строку и объявить перенос решённой задачей. Последняя строка уменьшает влияние алфавита и границ слов: её ухудшение показывает, что проблема не сводится к написанию. Это диагностический эксперимент, а не независимо выверенный новый эталон смешанной речи.
Источник. Оригинальное название: Nepali-English Code-Mixed Speech Recognition: Data Preparation and Adaptation of a Speech Foundation Model. arXiv:2611.13512; полный текст PDF.